
Vous mettez à jour la date d’un vieil article en espérant le rafraîchir, vous vous demandez si Google voit la différence entre un texte travaillé et un texte bâclé, et vous n’avez pour toute réponse que des conseils contradictoires. Les documents internes rendus publics en 2024 ne donnent aucune recette, mais ils nomment les champs — et pour plusieurs d’entre eux, un commentaire d’ingénieur explique précisément ce qu’ils contiennent. Cet article s’en tient à ces commentaires, et s’arrête là où ils s’arrêtent.
Quatre dates pour une seule page
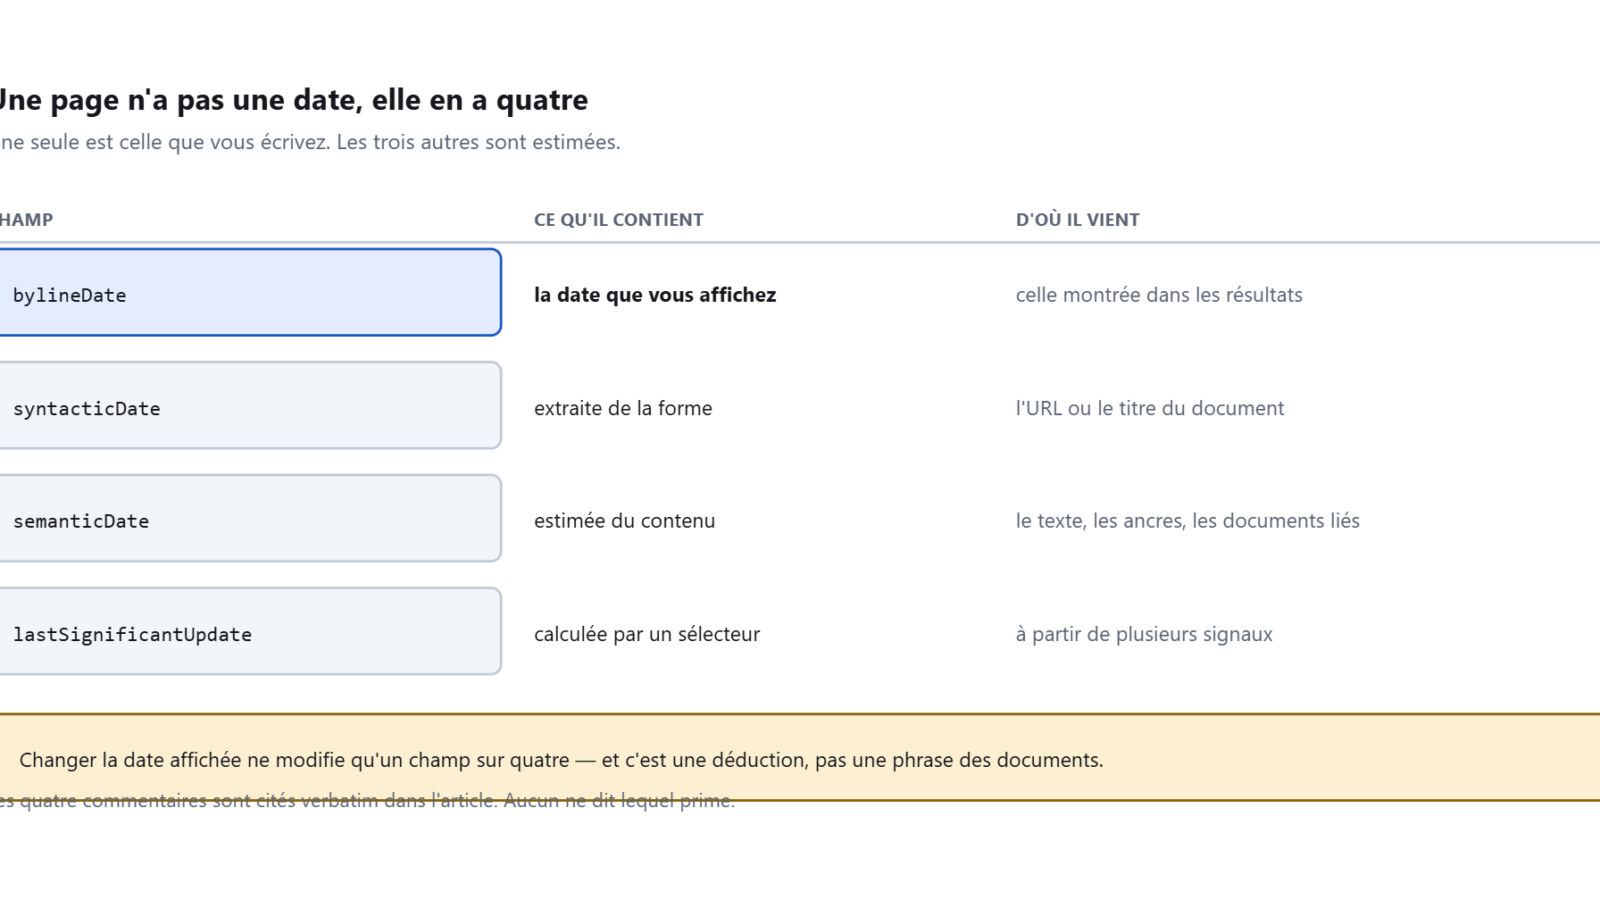
C’est la découverte la plus contre-intuitive du lot : une page n’a pas une date dans ces structures, elle en a quatre, calculées différemment.
bylineDate est celle que vous affichez : « Document’s byline date, if available: this is the date that will be shown in the snippets in web search results. » — la date de signature du document, celle qui sera montrée dans les extraits des résultats de recherche.
syntacticDate est celle que Google extrait de la forme : « Document’s syntactic date (e.g. date explicitly mentioned in the URL of the document or in the document title). » — la date explicitement mentionnée dans l’URL ou dans le titre du document.
semanticDate est de loin la plus intéressante : « SemanticDate, estimated date of the content of a document based on the contents of the document (via parsing), anchors and related documents. » — date estimée du contenu d’un document, établie à partir du contenu lui-même, des ancres, et des documents liés.
lastSignificantUpdate, enfin : « Last significant update of the document. This is sourced from the quality_timebased.LastSignificantUpdate proto as computed by the LSUSelector from various signals. » — dernière mise à jour significative, calculée par un sélecteur dédié à partir de plusieurs signaux.
Ce que ces quatre champs disent ensemble. La date que vous affichez est un champ parmi quatre, et c’est le seul que vous contrôlez directement. Trois autres sont estimés — dont un à partir de ce que les autres pages disent de la vôtre. Un changement de date sans changement de contenu ne modifie donc qu’une entrée sur quatre, et rien dans ces documents ne dit laquelle prime.
Un champ estime l’effort, et c’est un modèle de langage qui le fait
QualityNsrPQData.contentEffort porte le commentaire le plus court et le plus lourd de conséquence du dépôt : « LLM-based effort estimation for article pages. » — estimation de l’effort, fondée sur un grand modèle de langage, pour les pages d’article.
Trois mots comptent dans cette phrase. « Effort » : ce n’est ni la longueur, ni la fraîcheur, ni la popularité — c’est une notion de travail investi. « LLM-based » : l’estimation est faite par un modèle de langage, pas par une règle. « For article pages » : le champ est borné aux pages d’article, pas au web entier.
C’est le champ qui se rapproche le plus de ce que les évaluateurs humains de Google notent à la main, sujet traité dans l’article sur les quality raters. Et c’est aussi le plus proche du problème du contenu produit en série.
Ce que le commentaire ne dit pas, et qu’il ne faut donc pas lui faire dire : comment l’effort est estimé, sur quelle échelle, ni ce que le champ pèse.
L’originalité ne concerne que les pages pauvres
PerDocData.OriginalContentScore est cité partout comme « le score d’originalité de Google ». Son commentaire dit autre chose : « The original content score is represented as a 7-bits, going from 0 to 127. Only pages with little content have this field. The actual original content score ranges from 0 to 512. » — le score est représenté sur 7 bits, de 0 à 127 ; seules les pages à faible contenu ont ce champ ; le score réel, lui, va de 0 à 512.
La restriction est décisive et presque jamais reprise. Ce n’est pas une note d’originalité attribuée à tout le web : c’est un champ qui n’existe que sur les pages courtes. Autrement dit, le système cherche à distinguer une page courte qui apporte quelque chose d’une page courte qui ne fait que recopier.
Au passage, le commentaire dit aussi que la valeur stockée est une version compressée de la valeur réelle — de 0-512 vers 0-127 — ce qui perd de la finesse au profit de la place.
Google ne lit pas forcément toute votre page
DocProperties.numTokens compte les unités de texte d’un document, et son commentaire contient une réserve que peu de gens citent : « This is an approximation of the number of tokens, tags and punctuations we end up with in mustang, but is inexact since we drop some tokens in mustang and also truncate docs at a max cap. » — c’est une approximation, inexacte parce que certaines unités sont écartées et que les documents sont tronqués à un plafond maximal.
Le plafond n’est pas chiffré dans le commentaire, et aucune source publique ne le donne. Ce qui est établi, c’est le principe : au-delà d’une certaine taille, la fin d’un document n’est pas traitée. Rallonger un texte indéfiniment ne garantit donc pas que la matière ajoutée soit prise en compte.
Un dernier champ, pour finir sur le titre : QualityNsrNsrData.titlematchScore, « Titlematch score of the site, a signal that tells how well titles are matching user queries. » — un signal qui indique à quel point les titres correspondent aux requêtes des utilisateurs. Noter le mot « of the site » : la mesure est au niveau du site, pas de la page.
Cet article est un chapitre du dossier sur ce que ces documents changent concrètement pour un site.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Quatre champs de date distincts coexistent pour un même document | Documenté | Commentaires de bylineDate, syntacticDate, semanticDate, lastSignificantUpdate |
bylineDate est la date affichée dans les extraits de résultats |
Documenté | Commentaire du champ |
semanticDate est estimée à partir du contenu, des ancres et des documents liés |
Documenté | Commentaire du champ |
contentEffort est une estimation d’effort par un modèle de langage, bornée aux pages d’article |
Documenté | Commentaire du champ |
OriginalContentScore n’existe que sur les pages à faible contenu |
Documenté | Commentaire du champ |
La valeur stockée de OriginalContentScore est compressée de 0-512 vers 0-127 |
Documenté | Idem |
| Les documents sont tronqués à un plafond maximal | Documenté | Commentaire de numTokens |
titlematchScore est un signal au niveau du site, pas de la page |
Documenté | Commentaire du champ |
| Changer la date affichée ne modifie qu’un champ sur quatre | Déduit | Conséquence des quatre commentaires, jamais écrite telle quelle |
| « Google note l’originalité de toutes vos pages » | Faux | Le champ ne concerne que les pages à faible contenu |
| La valeur du plafond de troncature | Non documenté | Le principe est écrit, le chiffre ne l’est pas |
Comment contentEffort est calculé, et ce qu’il pèse |
Non documenté | Le commentaire donne la méthode générale, rien de plus |
Limites de cet article. Le dépôt décrit l’état d’un système interne au premier trimestre 2024 et n’a pas été mis à jour depuis : rien ne garantit que ces champs soient encore renseignés aujourd’hui. Aucun de ces commentaires ne donne de poids ni de seuil, et aucun ne permet de prédire l’effet d’une modification sur un site donné.
Questions fréquentes
Est-ce que changer la date d’un vieil article sert à quelque chose ? Ça modifie la date que vous affichez, donc probablement celle qui apparaît dans les résultats. Ça ne modifie pas les trois autres, dont une est estimée à partir du contenu et des pages qui vous lient. Les documents n’en disent pas plus.
Qu’est-ce qu’un contenu « à faible contenu » au sens de OriginalContentScore ?
Le commentaire ne le définit pas. Il dit seulement que le champ n’est renseigné que pour ces pages-là. Aucun seuil n’est donné, ni en mots, ni en unités de texte.
Faut-il écrire plus long pour être mieux traité ?
Rien dans ces champs ne va dans ce sens, et le commentaire de numTokens dit l’inverse à partir d’un certain point : les documents sont tronqués à un plafond. Un texte plus long n’est pas un texte davantage lu.
contentEffort veut-il dire que Google détecte les contenus générés ?
Le commentaire parle d’estimation d’effort par un modèle de langage sur des pages d’article, et rien de plus. Conclure qu’il s’agit d’un détecteur de contenu généré serait aller au-delà de ce qui est écrit.
Sources
- Miroir public du client Elixir ContentWarehouse, instantané du 27 mars 2024 — sur github.com