
Vous lisez quelque part que Google a « 14 000 critères de classement », ou que « l’autorité de domaine existe, la fuite l’a prouvé ». La source citée est toujours la même : des documents internes de Google rendus publics en 2024, plus un procès américain où des salariés de Google ont témoigné sous serment. Deux corpus réels, abondamment commentés, et rarement relus. Cet article part de ce que ces documents contiennent exactement — décompte à l’appui, script publié — sépare ce qu’ils établissent de ce qu’on leur fait dire, et en tire les quelques décisions qui changent pour un site, ainsi que celles qui ne changent pas.
Trois documents, et ce que chacun peut prouver
Ce qu’on appelle « la fuite Google » recouvre trois choses de nature très différente, et les confondre est l’erreur qui produit la plupart des articles faux sur le sujet.
Le dépôt d’API. Entre mars et mai 2024, un robot de publication automatique de Google a mis en ligne, sur une plateforme publique de code, la documentation d’un client logiciel interne nommé ContentWarehouse — un client étant simplement le bout de programme qui permet à un service d’en interroger un autre. Ce dépôt décrit des structures de données : des noms de champs, leurs types, et des commentaires écrits par des ingénieurs. Rand Fishkin l’a rendu public le 27 mai 2024, sur la base de documents transmis par Erfan Azimi ; Michael King en a publié l’analyse technique le lendemain.
Les transcriptions d’audience. Dans le procès antitrust United States v. Google LLC, jugé à Washington, des responsables de Google ont été interrogés sous serment. Le 18 octobre 2023, Pandu Nayak, vice-président chargé de la recherche, a répondu pendant des heures sur le fonctionnement du classement.
L’opinion du juge. Le 5 août 2024, le juge Amit Mehta a rendu une décision de 286 pages contenant des constatations de fait numérotées. Ce n’est ni Google qui parle, ni un journaliste : c’est un magistrat qui établit des faits à partir de témoignages et de pièces.
Ces trois sources n’ont pas la même force. Un nom de champ prouve qu’un champ existe. Un témoignage sous serment prouve ce qu’un salarié a déclaré. Une constatation de fait est ce qui se rapproche le plus d’une vérité établie — et c’est aussi la source la moins citée des trois.
Ce que contenait le dépôt — et ce qu’il en reste
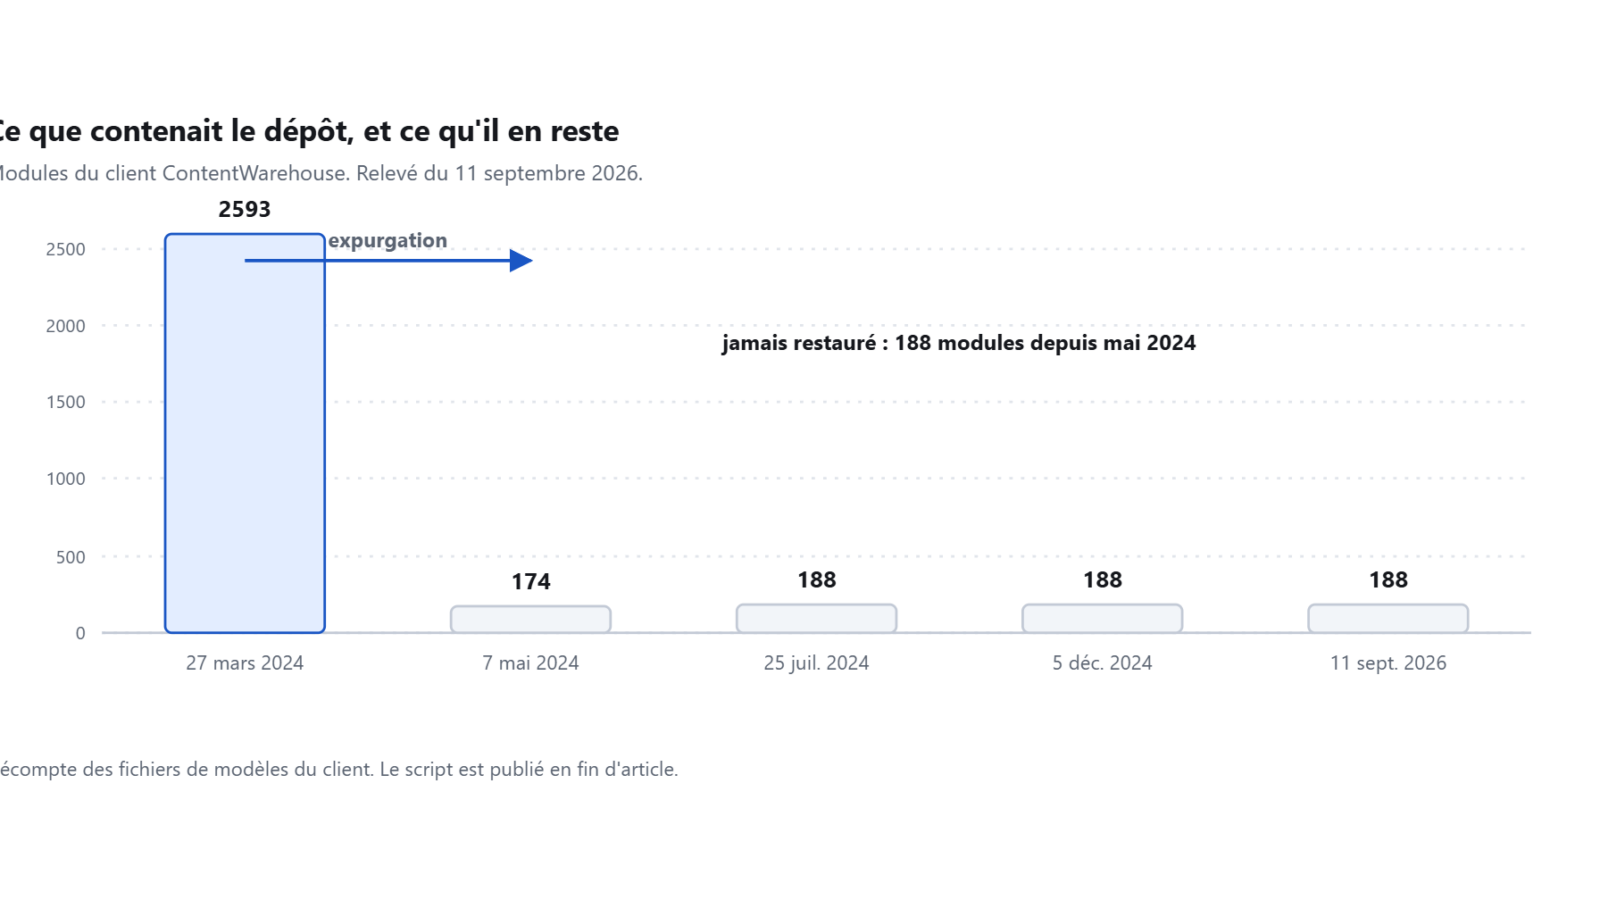
Un relevé existe déjà : Michael King, le 28 mai 2024, annonçait « 2,596 modules represented in the API documentation with 14,014 attributes » — 2 596 modules et 14 014 attributs. Voici un second relevé, fait pour cet article sur le dépôt public, avec le script publié plus bas.
| Date de l’instantané | État | Modules | Attributs |
|---|---|---|---|
| 27 mars 2024 | complet | 2 593 | 14 031 |
| 7 mai 2024 | expurgé | 174 | 594 |
| 25 juillet 2024 | expurgé | 188 | 630 |
| 5 décembre 2024 | expurgé | 188 | 630 |
| 11 septembre 2026 | expurgé | 188 | 630 |
Un module est ici un fichier décrivant une structure de données ; un attribut est un champ nommé à l’intérieur ; expurgé signifie que la partie interne a été retirée de la publication. Le décompte porte sur les fichiers du répertoire de modèles du client, et les attributs sont comptés sur les déclarations field(:…).
L’écart avec le relevé de King est de 0,1 % sur les deux colonnes, ce qui s’explique par la date de l’instantané — le dépôt a été régénéré trois fois entre mars et mai 2024 — et par la méthode de comptage. Les deux relevés concordent : l’ordre de grandeur n’est pas en cause. Ce qui suit l’est.
Deux résultats en sortent.
Le premier sert de témoin négatif : sur l’instantané expurgé du 7 mai, le même script, les mêmes motifs de recherche, le même dépôt donnent zéro correspondance sur boost, demot, promot, penalt, rerank et twiddl. Le script compte donc bien ce qu’il dit compter, et pas du bruit.
Le second est la série dans le temps, que les relevés ponctuels ne montrent pas : la documentation n’est jamais revenue dans ce dépôt. Le client y a été régénéré trois fois après l’expurgation — en juillet 2024, en décembre 2024 — et il en est toujours au même point au 11 septembre 2026, à 188 modules. Ce qui a fuité en mars 2024 est donc figé : c’est une photographie de l’état d’un système interne à une date, et cette photographie ne se met plus à jour.
« 14 000 critères de classement » : le chiffre le plus repris est le plus faux
Les 14 031 attributs mesurés ci-dessus sont régulièrement présentés comme autant de critères de classement. Le décompte par préfixe de module suffit à démonter l’affirmation.
| Préfixe de module | Produit concerné | Attributs | Part |
|---|---|---|---|
assistant |
Google Assistant | 1 311 | 9,3 % |
nlp |
traitement du langage | 1 105 | 7,9 % |
video |
vidéo et YouTube | 1 038 | 7,4 % |
indexing |
indexation — la mise en fiche des pages | 989 | 7,0 % |
quality |
qualité web | 910 | 6,5 % |
geostore |
Google Maps | 841 | 6,0 % |
apps |
Docs, Drive, agenda | 739 | 5,3 % |
photos |
Google Photos | 391 | 2,8 % |
Assistant, Maps, Photos, les applications bureautiques et la vidéo pèsent à eux seuls 30,8 % des attributs, contre 13,5 % pour l’indexation et la qualité web réunies. ContentWarehouse est un entrepôt de documents partagé par de nombreux produits de Google : compter ses champs comme des critères de classement revient à compter les rayons d’un supermarché comme des ingrédients d’une recette.
Ce qui reste vrai, et qui suffit largement : quelques centaines de champs concernent bien la recherche web, et certains portent des noms — et surtout des commentaires — qui ont fait sursauter la profession.
Les clics : le seul domaine couvert par les deux corpus
C’est le point où le dépôt et le procès se recoupent, et c’est ce qui en fait le plus solide du dossier.
Le dépôt nomme une structure QualityNavboostCrapsCrapsData qui contient les champs goodClicks, badClicks et lastLongestClicks — bons clics, mauvais clics, et dernier clic le plus long. Une structure voisine, QualityNavboostCrapsCrapsClickSignals, ajoute unicornClicks et unsquashedClicks. Le relevé donne 22 attributs dont le nom contient click dans l’instantané complet.
Le procès, lui, décrit le système. Le juge Mehta écrit, constatation de fait n° 96 : « Navboost is another signal that pairs queries and documents through memorizing user click data. » — Navboost est un signal qui apparie requêtes et documents en mémorisant les données de clic des utilisateurs. Et : « Prior to 2017, Google trained Navboost on 18 months of user data. Since then, it has trained Navboost on 13 months of user data. » — avant 2017, Google entraînait Navboost sur 18 mois de données ; depuis, sur 13 mois.
Six paragraphes plus loin, à la constatation n° 102, le juge cite une pièce versée au dossier sous la cote UPX190 pour établir que les systèmes fondés sur les grands modèles de langage n’ont pas remplacé Navboost : « Navboost remains one of the most power ranking components historically » [sic] — Navboost reste historiquement l’un des composants de classement les plus puissants.
Deux précautions, parce qu’elles sont systématiquement écrasées dans les reprises. Les 13 mois portent sur les données que Navboost mémorise et sur lesquelles il est entraîné, pas sur une politique générale de conservation des données chez Google — et la même fenêtre vaut pour QBST, un autre signal décrit à la constatation n° 95. Et Nayak a relativisé Navboost dans le même interrogatoire : « So I think it is fair to say that navboost is not the only factor. » — il paraît juste de dire que Navboost n’est pas le seul facteur.
Le détail du mécanisme est traité dans l’article consacré à NavBoost et aux signaux de clic, et le dispositif technique qui enregistre le clic avant de vous envoyer sur le site est décrit dans celui sur google.com/goto.
Liens, contenu, dates : ce que les commentaires disent en plus des noms
Le reste du dépôt donne des noms de champs — et, pour certains, un commentaire d’ingénieur qui en dit bien davantage. C’est la partie la moins lue, et la plus instructive.
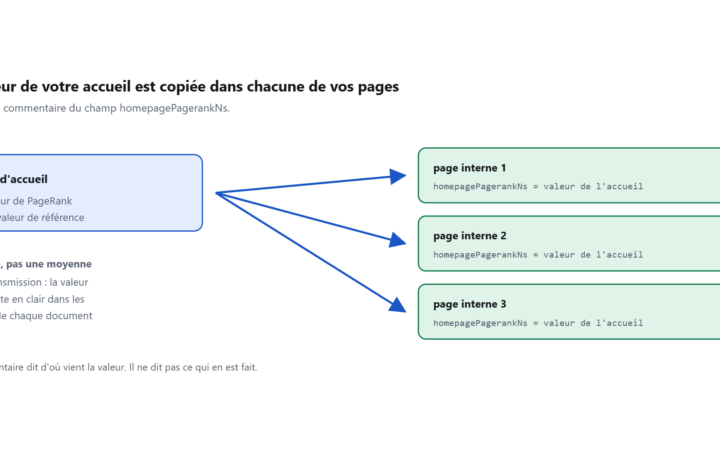
Sur les liens et l’autorité : siteAuthority, dans une structure nommée CompressedQualitySignals, avec ce commentaire : « site_authority: converted from quality_nsr.SiteAuthority, applied in Qstar. » — converti depuis un autre signal, et appliqué dans un système nommé Qstar.
Sur le contenu : OriginalContentScore, dont le commentaire porte une restriction majeure — « Only pages with little content have this field. » — seules les pages à faible contenu ont ce champ. Ce n’est donc pas une note d’originalité attribuée à tout le web, contrairement à ce qu’on lit souvent.
Sur le titre : titlematchScore, « a signal that tells how well titles are matching user queries » — un signal qui indique à quel point les titres correspondent aux requêtes des utilisateurs.
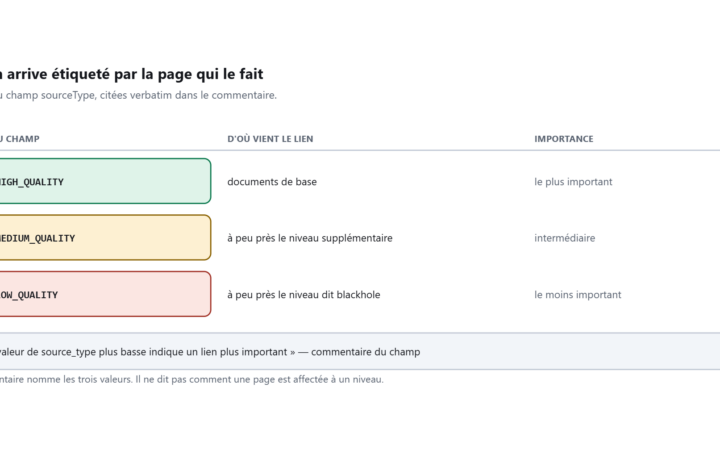
Sur l’âge du site : hostAge, dont le commentaire est le plus explicite du lot — « These data are used in twiddler to sandbox fresh spam in serving time. » — ces données servent, dans un twiddler, à mettre en quarantaine le spam récent au moment de servir les résultats. Les twiddlers sont les modules qui retouchent le classement une fois celui-ci calculé ; ils sont traités dans l’article qui leur est consacré.
Et c’est là qu’il faut être précis, parce que presque tous les commentaires dérapent. Ces champs franchissent deux marches : leur nom existe, et leur point d’application est parfois décrit. Ils n’en franchissent pas une troisième : aucun commentaire, aucune pièce du procès, aucune déclaration publique ne donne le poids de l’un de ces champs dans le classement. Entre « siteAuthority existe et est appliqué dans Qstar » et « l’autorité de domaine vaut tant dans le classement », il manque la seule information qui permettrait d’en faire une priorité de travail.
Les retouches d’après classement, et les sites traités à part
Le dépôt nomme 19 attributs dont le nom contient demot — démotion, c’est-à-dire rétrogradation. Plusieurs sont explicites : exactMatchDomainDemotion pour les noms de domaine correspondant exactement à une requête, anchorMismatchDemotion pour les ancres de liens qui ne correspondent pas à la page visée, navDemotion, productReviewPDemotePage et productReviewPDemoteSite pour les avis produits, serpDemotion.
Dans l’autre sens, smallPersonalSite n’est pas un marqueur mais un score, et son commentaire annonce une promotion, pas une sanction : « Score of small personal site promotion ». Deux champs booléens, isElectionAuthority et isCovidLocalAuthority, marquent les sites faisant autorité sur les élections et sur l’information locale liée au Covid — et leur commentaire précise « as computed by », calculé par un service interne. Ce sont donc des classifications calculées, et non des listes tenues à la main, qui est la lecture la plus souvent proposée.
À ne pas confondre avec les core updates ni les spam updates, qui sont des mises à jour annoncées, alors que ces retouches-là sont permanentes et silencieuses.
Ce que Google a répondu — et ce que ça vaut
Le 29 mai 2024, un porte-parole de Google a transmis cette déclaration à Search Engine Land : « We would caution against making inaccurate assumptions about Search based on out-of-context, outdated, or incomplete information. We’ve shared extensive information about how Search works and the types of factors that our systems weigh, while also working to protect the integrity of our results from manipulation. » — Nous mettons en garde contre les suppositions inexactes sur la recherche, fondées sur des informations sorties de leur contexte, périmées ou incomplètes. Nous avons largement communiqué sur le fonctionnement de la recherche et sur les types de facteurs que nos systèmes pondèrent, tout en travaillant à protéger nos résultats de la manipulation.
Cette déclaration ne dit rien de l’authenticité des documents, ni pour ni contre. Elle attaque leur lecture, sur trois angles : hors contexte, périmés, incomplets. Le relevé de la deuxième section donne raison à Google sur au moins un des trois — les documents sont bien figés depuis mai 2024 — sans rien dire des deux autres.
Ce qu’il faut en retenir tient en une phrase : c’est l’interprétation des documents qui est contestée, et non leur contenu. Ce qui déplace la question de « peut-on y croire » vers « qu’est-ce qu’on a le droit d’en déduire », qui est la bonne question.
Ce que ça change vraiment pour votre site
Trois décisions changent.
Traiter le clic comme un résultat, pas comme un levier. Puisque Navboost mémorise des clics sur 13 mois, un titre et une description qui décrivent honnêtement la page valent mieux qu’un titre qui fait cliquer et déçoit — le badClick est nommé dans les documents. Chercher à fabriquer des clics est une autre affaire : les tests terrain publiés montrent un gain de position temporaire suivi d’un retour au point de départ, et le mécanisme décrit au procès mémorise aussi les mauvais clics.
Vérifier la cohérence de vos ancres de liens. anchorMismatchDemotion est un nom de champ, donc une piste, pas une preuve — mais le coût d’une ancre qui décrit honnêtement la page qu’elle vise est nul. Le sujet est traité dans le guide du maillage interne.
Prévoir de la patience sur un site tout neuf. Le commentaire de hostAge documente une mise en quarantaine du spam récent au moment de servir les résultats. Il n’établit pas que tout site neuf est ralenti — mais il établit que l’âge du domaine est utilisé quelque part, ce qui a longtemps été présenté comme un mythe de référenceur.
Et trois non-décisions, qui coûtent plus cher que les décisions.
Ne pas acheter un outil sur la promesse de « suivre les facteurs de la fuite ». Les documents ne donnent le poids d’aucun champ.
Ne pas refondre un site pour « l’autorité de domaine ». Le champ existe et son point d’application est nommé ; sa formule et son poids ne le sont pas. Et les scores d’autorité affichés par les outils du marché sont calculés par ces outils, pas par Google.
Ne pas traiter ces documents comme une liste de critères. Ils décrivent un entrepôt de données partagé par une douzaine de produits, à une date qui remonte maintenant à plus de deux ans.
Trois chapitres de ce dossier sont ouverts. Ce que Google mesure des clics de vos visiteurs, ce que les documents établissent sur les liens et l’autorité, et les champs qui jugent le contenu de vos pages.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Le dépôt public contenait 2 593 modules et 14 031 attributs au 27/03/2024 | Mesuré | Relevé de cet article, script publié |
| Un relevé antérieur donne 2 596 modules et 14 014 attributs | Documenté | Michael King, iPullRank, 28/05/2024 |
| Il est tombé à 174 modules le 07/05/2024, et reste à 188 au 11/09/2026 | Mesuré | Relevé de cet article, 5 instantanés |
Zéro correspondance boost/demot/twiddl dans l’instantané expurgé |
Mesuré | Témoin négatif du même script |
| Assistant, Maps, Photos, bureautique et vidéo pèsent 30,8 % des attributs | Mesuré | Relevé par préfixe de module |
Les champs goodClicks, badClicks, lastLongestClicks existent |
Documenté | Dépôt, QualityNavboostCrapsCrapsData |
| Navboost apparie requêtes et documents en mémorisant les clics | Documenté | Opinion Mehta, 05/08/2024, constatation n° 96 |
| Navboost est entraîné sur 13 mois de données, 18 avant 2017 | Documenté | Opinion Mehta, constatation n° 96, sur témoignage Nayak |
| « Navboost reste l’un des composants de classement les plus puissants », mais n’est pas le seul facteur | Documenté | Pièce UPX190 à la constatation n° 102 ; témoignage Nayak du 18/10/2023 |
siteAuthority est converti d’un autre signal et appliqué dans Qstar |
Documenté | Commentaire du champ, dépôt |
OriginalContentScore ne concerne que les pages à faible contenu |
Documenté | Commentaire du champ, dépôt |
hostAge sert à mettre en quarantaine le spam récent, via un twiddler |
Documenté | Commentaire du champ, dépôt |
smallPersonalSite est un score de promotion et isElectionAuthority une classification calculée |
Documenté | Commentaires des champs, dépôt |
| « Google a 14 000 critères de classement » | Faux | La majorité des attributs relève d’autres produits |
| « Google conserve 13 mois de données de clic » | Imprécis | Les 13 mois sont la fenêtre mémorisée par Navboost, pas une politique de rétention générale |
| La déclaration de Google du 29/05/2024 vaut reconnaissance d’authenticité | Déduit | Elle ne dit rien de l’authenticité, ni pour ni contre |
| Le poids de chaque champ dans le classement | Non documenté | Ni le dépôt ni le procès ne le donnent |
| Si les champs nommés sont encore utilisés en 2026 | Non documenté | Le dépôt est figé depuis mai 2024 |
Limites de cet article. Le relevé porte sur le miroir public du client Elixir, pas sur les documents d’origine de Google : il mesure ce qui a été publié, pas ce qui existe chez Google. Les constatations du juge Mehta reposent sur des témoignages et des pièces dont certaines ne sont pas publiques — les pièces UPX190 et UPX196, qui décrivent Navboost, ne figurent pas parmi les documents publiés par le ministère de la Justice, et n’ont été lues qu’à travers les fragments qu’en reproduit l’opinion. Enfin, les sections de l’opinion de septembre 2025 consacrées au partage des données d’interaction n’ont pas pu être consultées : elles pourraient contenir des constatations plus récentes sur les clics.
Le script de mesure
Nul besoin de lire ce code pour vérifier les chiffres de cet article : il suffit de le relancer.
import re, glob, os
FIELD = re.compile(r"^\s*field\(:([A-Za-z0-9_]+)", re.M)
MODELS = "{}/clients/content_warehouse/**/v1/model/*.ex"
SNAPSHOTS = [("2024-03-27", "snap_e7e99f57"), ("2024-05-07", "snap_078b497f"),
             ("2024-07-25", "snap_aca35e3e"), ("2024-12-05", "snap_7728c71e")]
for label, d in SNAPSHOTS:
    files = glob.glob(MODELS.format(d), recursive=True)
    attrs, prefixes = [], {}
    for f in files:
        noms = FIELD.findall(open(f, encoding="utf-8", errors="replace").read())
        attrs += noms
        p = os.path.basename(f).split("_")[0]
        prefixes[p] = prefixes.get(p, 0) + len(noms)
    print(label, len(files), "modules", len(attrs), "attributs")
    for m in ["boost", "demot", "promot", "penalt", "rerank", "twiddl"]:
        rx = re.compile(m, re.I)
        print("   motif", m, sum(1 for a in attrs if rx.search(a)))
    for p, n in sorted(prefixes.items(), key=lambda x: -x[1])[:8]:
        print("   prefixe", p, n, "attributs", round(100 * n / len(attrs), 1), "%")
Les instantanés se récupèrent par git fetch --depth 1 sur le miroir public du client, aux commits du 27 mars, du 7 mai, du 25 juillet et du 5 décembre 2024. Les trois faux positifs adaboost — un algorithme d’apprentissage sans rapport — sont à retirer à la main du décompte sur boost.
Questions fréquentes
Pourquoi ces documents ont-ils été publiés par Google lui-même ? Un robot de publication automatique génère et met en ligne les clients logiciels de nombreuses API de Google. Il a publié celui de ContentWarehouse sans que son contenu interne ait été retiré, et la publication a été expurgée le 7 mai 2024.
Peut-on encore consulter le contenu de la fuite ? Le dépôt public ne le sert plus depuis mai 2024. Des copies et des transcriptions circulent, et c’est sur une copie de ce dépôt, récupérée à ses versions de mars 2024, que reposent les relevés de cet article.
Le procès antitrust portait-il sur le référencement ? Non. Il porte sur un abus de position dominante. Le classement n’y est décrit que parce que la valeur des données d’interaction est au cœur du dossier — ce qui explique pourquoi les constatations sont détaillées sur les clics et presque muettes sur le reste.
Pourquoi les commentaires de champs sont-ils plus utiles que les noms ?
Parce qu’un nom se prête à toutes les interprétations, alors qu’un commentaire donne parfois une restriction décisive. OriginalContentScore sonne comme une note d’originalité valable pour tout le web ; son commentaire dit qu’il ne concerne que les pages à faible contenu.
Faut-il refaire son SEO à la lumière de ces documents ? Les documents confirment des mécanismes, ils ne fournissent aucune pondération. Ils servent à écarter de mauvaises priorités bien plus qu’à en créer de nouvelles — d’où les trois non-décisions plus haut.
Sources
- Opinion du juge Amit Mehta, United States v. Google LLC, n° 20-cv-3010, 5 août 2024 — constatations de fait n° 86 à 104 — sur courtlistener.com
- Transcription d’audience du 18 octobre 2023, témoignage de Pandu Nayak — sur thecapitolforum.com
- Déclaration de Google, 29 mai 2024 — sur searchengineland.com
- Michael King, analyse du 28 mai 2024 — sur ipullrank.com
- Miroir public du client Elixir ContentWarehouse, instantanés de mars à décembre 2024 — sur github.com