
« Un lien de qualité vaut mieux que cent liens pourris » est le conseil le plus répété du référencement, et le moins démontré : personne ne dit ce que « qualité » recouvre côté Google. La documentation interne publiée en 2024 ne donne pas de barème, mais elle nomme les champs — et l’un d’eux classe explicitement chaque lien selon la page qui le fait. Voici ce que ces champs établissent, et où ils s’arrêtent.
Chaque lien porte la qualité de sa page source, sur trois niveaux
C’est le champ le plus explicite de tout le dossier sur les liens, et il est rarement cité en entier. AnchorsAnchor.sourceType :
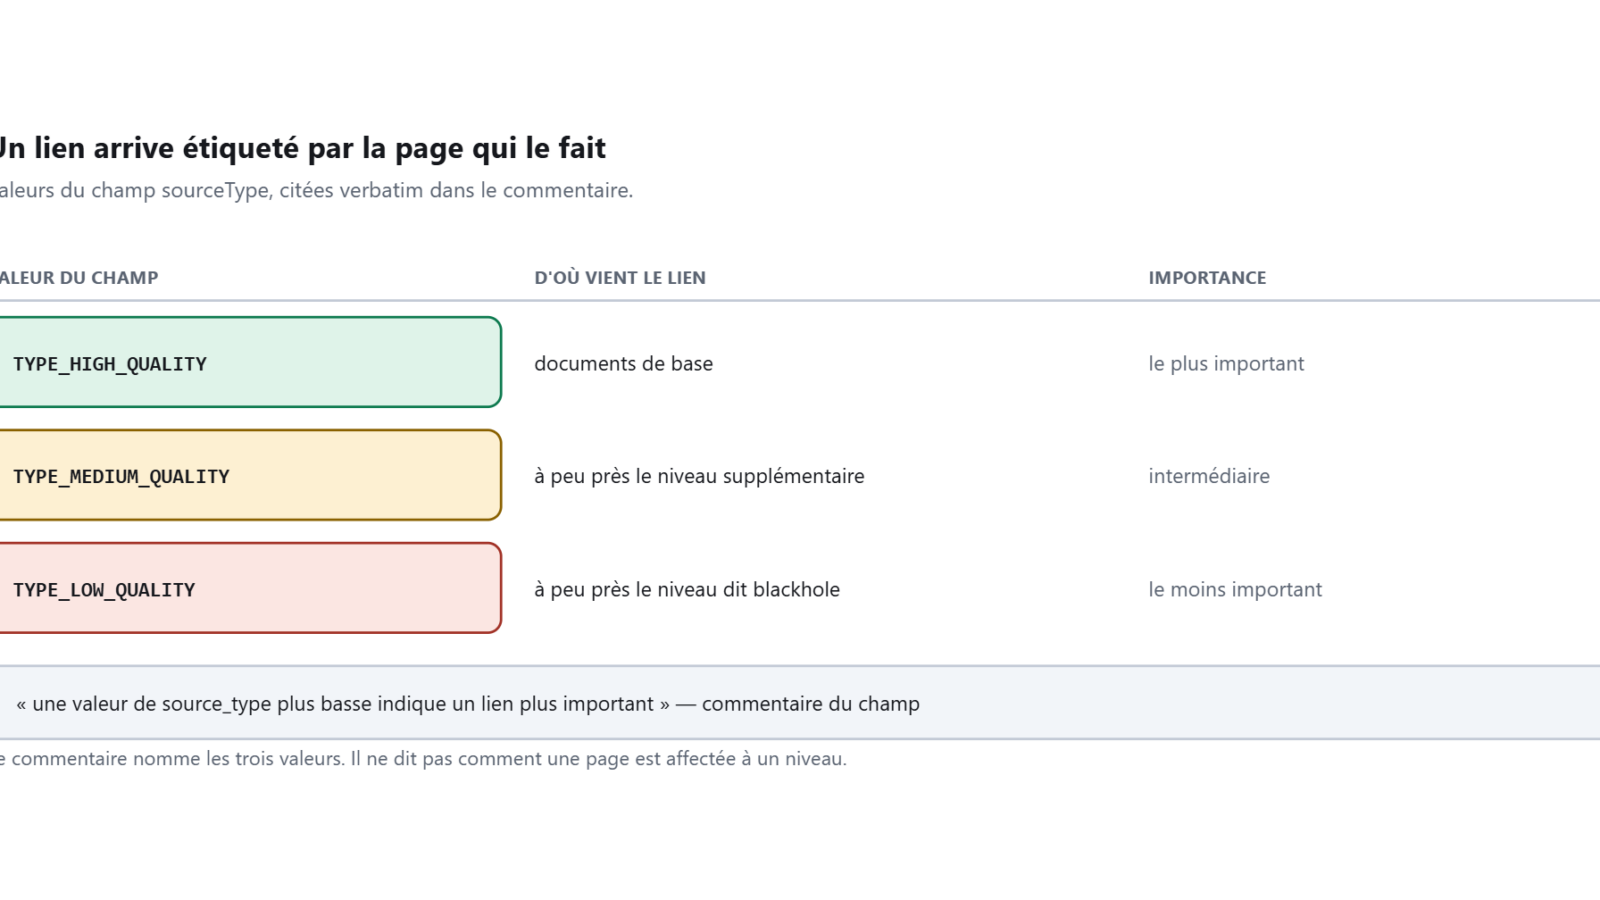
« is to record the quality of the anchor’s source page and is correlated with but not identical to the index tier of the source page. […] Anchors marked TYPE_HIGH_QUALITY are from base documents. Anchors marked TYPE_MEDIUM_QUALITY are from documents of medium quality (roughly but not exactly supplemental tier documents). Anchors marked TYPE_LOW_QUALITY are from documents of low quality (roughly but not exactly blackhole documents). »
En français : ce champ enregistre la qualité de la page source du lien ; elle est corrélée, sans être identique, au niveau d’index de cette page. Les liens marqués haute qualité viennent de documents de base ; ceux marqués qualité moyenne, de documents à peu près équivalents au niveau supplémentaire ; ceux marqués basse qualité, de documents à peu près équivalents au niveau dit blackhole.
Le commentaire ajoute une précision d’ingénieur qui vaut d’être lue : « the source_type can also be used as an importance indicator of an anchor (a lower source_type value indicates a more important anchor) » — le type de source sert aussi d’indicateur d’importance du lien, une valeur plus basse indiquant un lien plus important.
Ce que ça établit. Un lien n’entre pas dans le système comme une unité neutre : il arrive étiqueté par le niveau d’index de la page qui l’émet, sur trois valeurs nommées. Et cette étiquette sert d’indicateur d’importance.
Ce que ça n’établit pas. Comment une page est affectée à un niveau, quel écart sépare les trois valeurs, et ce que le champ pèse dans le classement. Rien de tout cela n’est dans le commentaire.
Des liens sont jetés avant même d’être comptés
Deux champs, dans la structure qui agrège les liens d’un document, comptent des liens écartés. Anchors.localAnchorsDropped : « The total # of local non-homepage anchors dropped in AnchorAccumulator. » — le nombre total de liens internes, hors page d’accueil, écartés à l’accumulation. Et Anchors.homepageAnchorsDropped, qui compte la même chose pour les liens venus de pages d’accueil.
Un troisième, IndexingDocjoinerAnchorStatistics.droppedHomepageAnchorCount, porte le même objet — sans aucun commentaire.
L’existence d’un compteur de liens jetés dit deux choses. D’abord que tous les liens collectés ne sont pas retenus : il existe une étape d’accumulation où certains sont écartés. Ensuite que le nombre de liens jetés est lui-même conservé comme une donnée — ce n’est pas un déchet, c’est un compte.
Le commentaire ne dit pas selon quelle règle un lien est écarté. C’est la limite dure de cette section.
Plusieurs liens depuis la même page vers le même site sont comptés à part
AnchorsAnchor.parallelLinks : « The number of additional links from the same source page to the same target domain. Not populated if is_local is true. » — le nombre de liens supplémentaires depuis la même page source vers le même domaine cible ; non renseigné si le lien est interne.
Ce champ répond à une question ancienne : que se passe-t-il quand une page pointe cinq fois vers votre site ? Les documents disent que les liens supplémentaires sont comptés séparément, dans un champ dédié. Ils ne disent ni qu’ils sont ignorés, ni qu’ils comptent à plein.
La précision finale est celle qui intéresse le plus : le champ n’est pas renseigné pour les liens internes. Le compte des liens parallèles concerne donc les liens entrants d’un autre domaine, et le maillage interne relève d’une autre mécanique — traitée dans la méthode de maillage interne en cinq étapes.
Deux marqueurs collés à la source du lien
AnchorsAnchor.expired : « true iff exp domain » — vrai si et seulement si le domaine est expiré. Cinq mots. Le champ existe, il est booléen, et le sujet est traité plus largement dans l’article consacré au nom de domaine.
AnchorsAnchor.isLocal : « The bit ~roughly~ indicates whether an anchor’s source and target pages are on the same domain. » — le bit indique à peu près si la source et la cible sont sur le même domaine. Les tildes autour de « roughly » sont dans le commentaire d’origine : l’ingénieur signale lui-même que le bit n’est pas fiable au sens strict.
Ces deux marqueurs disent que la nature de la source est conservée avec le lien, pas recalculée au moment de servir.
Ce que « qualité d’un lien » veut dire dans ces documents
Deux champs de la même structure portent des noms qui ressemblent à une réponse : locality et bucket. Leur commentaire déçoit et instruit à la fois : « For ranking purposes, the quality of an anchor is measured by its « locality » and « bucket ». » — pour le classement, la qualité d’un lien se mesure par sa « localité » et son « seau ». La suite du commentaire renvoie à un fichier interne, quality/anchors/definitions.h, qui n’a pas fuité.
C’est donc écrit noir sur blanc : la qualité d’un lien est mesurée par deux dimensions nommées, dont la définition n’est pas publique. bucket n’a lui-même aucun commentaire propre.
Deux autres champs stockent une date. firstseenDate : le nombre de jours depuis fin 1994 où le lien a été vu pour la première fois, sur quinze bits au plus. creationDate : « used for history – the first and last time we have seen this anchor » — utilisé pour l’historique, la première et la dernière fois que ce lien a été vu. L’historique d’un lien est donc conservé, sa disparition comprise.
Cet article détaille un point de la page qui demande s’il faut encore faire du netlinking. Voir aussi le texte d’ancre et ses démotions.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Chaque lien porte un type de source sur trois valeurs : haute, moyenne, basse qualité | Documenté | Commentaire de sourceType |
| Ce type est corrélé au niveau d’index de la page source, sans lui être identique | Documenté | Idem |
| Le type de source sert aussi d’indicateur d’importance du lien | Documenté | Idem |
| Des liens sont écartés à l’accumulation, et leur nombre est compté | Documenté | Commentaires de localAnchorsDropped et homepageAnchorsDropped |
| Les liens supplémentaires d’une même page vers un même domaine sont comptés dans un champ dédié | Documenté | Commentaire de parallelLinks |
| Ce compte n’existe pas pour les liens internes | Documenté | Idem |
| Un booléen marque le domaine expiré | Documenté | Commentaire de expired |
| La qualité d’un lien est mesurée par sa « localité » et son « seau » | Documenté | Commentaire de locality |
| La première et la dernière apparition d’un lien sont conservées | Documenté | Commentaires de firstseenDate et creationDate |
bucket et droppedHomepageAnchorCount n’ont aucun commentaire |
Mesuré | Relevé des commentaires du dépôt |
| « Les liens d’une même page au-delà du premier sont ignorés » | Non documenté | Le champ compte les liens supplémentaires ; il ne dit pas ce qu’on en fait |
| La règle selon laquelle un lien est écarté | Non documenté | Les compteurs existent, la condition n’est nulle part |
| La définition de « localité » et de « seau » | Non documenté | Le commentaire renvoie à un fichier interne qui n’a pas fuité |
| Le poids de l’un quelconque de ces champs dans le classement | Non documenté | Aucune source publique ne le donne |
Limites de cet article. Le dépôt décrit l’état d’un système interne au premier trimestre 2024 et n’a pas été mis à jour depuis : rien ne garantit que ces champs soient encore renseignés aujourd’hui. Un nom de champ et son commentaire établissent une existence, parfois une méthode générale, jamais un effet mesurable sur un site donné.
Questions fréquentes
Comment savoir si mes liens viennent de pages « haute qualité » ? Vous ne pouvez pas. Le type de source est une valeur interne, corrélée à un niveau d’index qu’aucun outil extérieur n’observe. Ce que les documents établissent, c’est que la distinction existe et qu’elle est stockée avec le lien.
Un lien depuis une page de mauvaise qualité fait-il du tort ? Le commentaire dit qu’un lien depuis une page de basse qualité est marqué comme tel et compte comme moins important. Il ne dit nulle part qu’il soustrait quoi que ce soit. Importance moindre et pénalité sont deux choses différentes, et une seule des deux est documentée ici.
Mettre plusieurs liens vers le même site depuis une page, est-ce utile ?
Le champ parallelLinks compte ces liens supplémentaires séparément, ce qui indique au minimum qu’ils ne sont pas traités comme le premier. Aucune source publique ne dit ce qu’ils valent.
Un vieux lien vaut-il plus qu’un lien récent ? Les documents stockent la date de première apparition d’un lien et l’historique de ses apparitions. Ils n’en tirent aucune règle écrite. Déduire qu’un lien ancien pèse davantage serait aller au-delà du texte.
Sources
- Miroir public du client Elixir ContentWarehouse, instantané du 27 mars 2024 — sur github.com