
Vous voyez passer depuis le 30 septembre des résumés du Search Central Live de Barcelone, et ils ne disent pas tous la même chose : chiffres qui varient, mécanismes internes présentés comme des annonces, éléments venus d’ailleurs mêlés à ce que Google a dit. Google n’a publié ni les diapositives, ni de transcription. Cet article reprend les trois jours dans l’ordre où Google les a construits — exploration, indexation, classement —, confronte chaque point à la documentation que Google a alignée sur ses présentations le 1er octobre, et signale ce qui ne repose que sur un seul témoin. Il en tire ce qui change, concrètement, pour un site.
À jour au 6 octobre 2026.
Exploration : un seul Googlebot pour la recherche et ses réponses IA
Le Search Central Live Deep Dive Europe s’est tenu à Barcelone du 30 septembre au 2 octobre 2026, en anglais, sans traduction. Google l’avait annoncé comme un « parcours d’étude » plutôt qu’une conférence : un jour par étape du moteur, dans l’ordre où une page la traverse. Explorer, c’est la visite de la page par le robot ; indexer, c’est la ranger dans l’index, la base où Google cherche ses résultats ; classer, c’est choisir l’ordre d’affichage.
Le premier jour, Gary Illyes et Cherry Prommawin, de l’équipe Search Relations (les porte-parole techniques de Google auprès des sites), ont posé le point qui a le plus circulé : la recherche classique, l’Aperçu IA (AI Overviews, le résumé généré en haut des résultats) et le Mode IA (AI Mode, la recherche conversationnelle) sont alimentés par le même Googlebot — le robot qui parcourt le web pour le compte de Google. Le compte rendu de John Campbell (agence ROAST), seul à détailler ce passage, ajoute que Gemini, l’assistant, utiliserait un robot distinct. La documentation de Google décrit autre chose : pour Gemini, elle prévoit un jeton de contrôle, Google-Extended, qui « ne dispose pas d’une chaîne user-agent de requête HTTP distincte ».
Le point principal, lui, recoupe la documentation. Les fonctionnalités d’IA générative de Google « reposent sur nos principaux systèmes de classement et de qualité de la Recherche », et une page doit, pour y figurer, « être indexée et éligible à l’affichage dans la recherche Google avec un extrait » — l’extrait étant le texte affiché sous le titre d’un résultat. La phrase suivante ajoute une condition : le site doit aussi être inclus dans les fonctionnalités d’IA générative dans la Search Console, l’outil gratuit de Google pour suivre un site.
Sur le budget d’exploration — le volume de pages que Google accepte de visiter sur un site —, Cherry Prommawin a rappelé ses deux composantes. La documentation les détaille : la limite augmente si le site répond vite, temps de réponse et TTFB (le délai avant le premier octet de réponse) compris, et elle diminue s’il « répond par des erreurs de serveur ». La même page précise qu’elle vise surtout les sites de plus de 10 000 pages qui changent chaque jour, ou de plus d’un million de pages.
Indexation : ce que Google voit vraiment d’une page
Le deuxième jour portait sur ce qui se passe entre la visite du robot et l’entrée dans l’index.
Le rendu ne fait ni défiler ni cliquer. Erin Sparling l’a expliqué sur scène, et c’est documenté de longue date : « la recherche Google n’interagit pas avec votre page ». Le rendu, c’est l’étape où Google exécute le JavaScript (le code qui construit une partie de la page dans le navigateur) pour obtenir la page telle qu’un visiteur la voit. Le risque porte sur le contenu qui n’est chargé qu’au clic ou au défilement. Un texte présent dans le code mais masqué derrière un onglet n’est pas concerné : Google le compte dans le contenu principal.
Le contenu principal pèse plus que le reste. La page de Google sur le contenu utile, mise à jour juste après l’événement, en donne la définition : « La recherche Google définit le « contenu principal » comme toute partie de la page Web qui l’aide directement à atteindre son objectif. » Elle rappelle que, pour les évaluateurs de Google, « l’un des facteurs les plus importants pour évaluer la qualité d’une page est la qualité du contenu principal ».
Deux directives à laisser larges. Selon le compte rendu de ROAST, John Mueller a recommandé, pour qui veut être visible, la balise meta robots (l’instruction placée dans le code de la page) avec max-image-preview:large (autoriser les grandes vignettes) et max-snippet:-1 (pas de limite à la longueur de l’extrait). Il a aussi traité la duplication : redirections et balise canonical restent les outils pour indiquer à Google la version à garder — le sujet est détaillé dans l’article sur le contenu dupliqué.
Les erreurs internationales les plus fréquentes. Cherry Prommawin a cité, pour hreflang (l’attribut qui signale les versions linguistiques d’une page), deux erreurs : déclarer les versions par plusieurs méthodes à la fois, et employer de mauvais codes de langue.
Classement : la qualité fait le tri avant le classement
Le troisième jour suivait la requête jusqu’à la page de résultats.
Gary Illyes a décrit la récupération — l’étape où Google extrait de son index les pages candidates — comme distincte du classement, avec la qualité comme critère qui tranche. Nacho Mascort, présent dans la salle, le formule ainsi : la qualité arrive comme un attribut de l’URL (l’adresse de la page), à côté de la langue ou du pays, calculé avant même la recherche. Google n’a pas publié ce mécanisme.
Duy Nguyen, analyste qualité chez Google, a précisé qu’il n’existe pas un algorithme unique de la qualité mais de nombreux systèmes, et que la qualité se juge de la même façon qu’un contenu vienne d’une personne ou d’une IA. Il a présenté quatre attributs : effort, originalité, talent ou compétence, exactitude.
Ces quatre attributs sont désormais écrits noir sur blanc. Le 1er octobre, Google a mis à jour sa documentation sur les contenus générés par IA, avec cette justification : « To get our documentation in sync with our presentations we use at our developer events » (pour aligner notre documentation sur les présentations que nous faisons lors de nos événements pour développeurs). Sa page sur le contenu utile, dont la dernière mise à jour est datée du 5 octobre, introduit les quatre attributs ainsi : « les évaluateurs de la qualité de la recherche sont formés pour évaluer les attributs fondamentaux suivants du contenu principal ». Les évaluateurs de la qualité sont les personnes que Google paie pour noter des résultats ; leurs notes servent à juger des changements d’algorithme, pas à classer une page — voir l’article sur les quality raters. La définition de l’effort vise directement la production automatisée : « générer automatiquement des pages à partir de flux ou utiliser l’IA générative pour produire de grandes quantités de texte sans supervision ni sélection humaines ne demandent que peu ou pas d’effort. »
Le guide de Google pour l’IA générative, en vigueur depuis juillet, donne l’exemple type de ce qui manque d’originalité : « Un contenu générique (par exemple, « sept conseils aux primo-accédants ») repose souvent sur des connaissances générales pouvant provenir de n’importe qui ». C’est le profil de page le plus exposé, et celui que produit le slop IA.
Côté spam, Gary Illyes a repris un ordre de grandeur que Google publie déjà : « Our systems find 40 billion spammy pages every day » (nos systèmes détectent 40 milliards de pages de spam chaque jour).
Enfin, selon ROAST, Eric Murillo, de l’équipe Trust & Safety de Discover (le fil d’articles proposé sur mobile sans requête), a démonté une idée reçue : il n’existe pas de robot dédié à Discover. Pour les images, il a recommandé au moins 1 200 pixels de large, un format 16:9 et la directive max-image-preview:large.
Les délais présentés par Gary Illyes
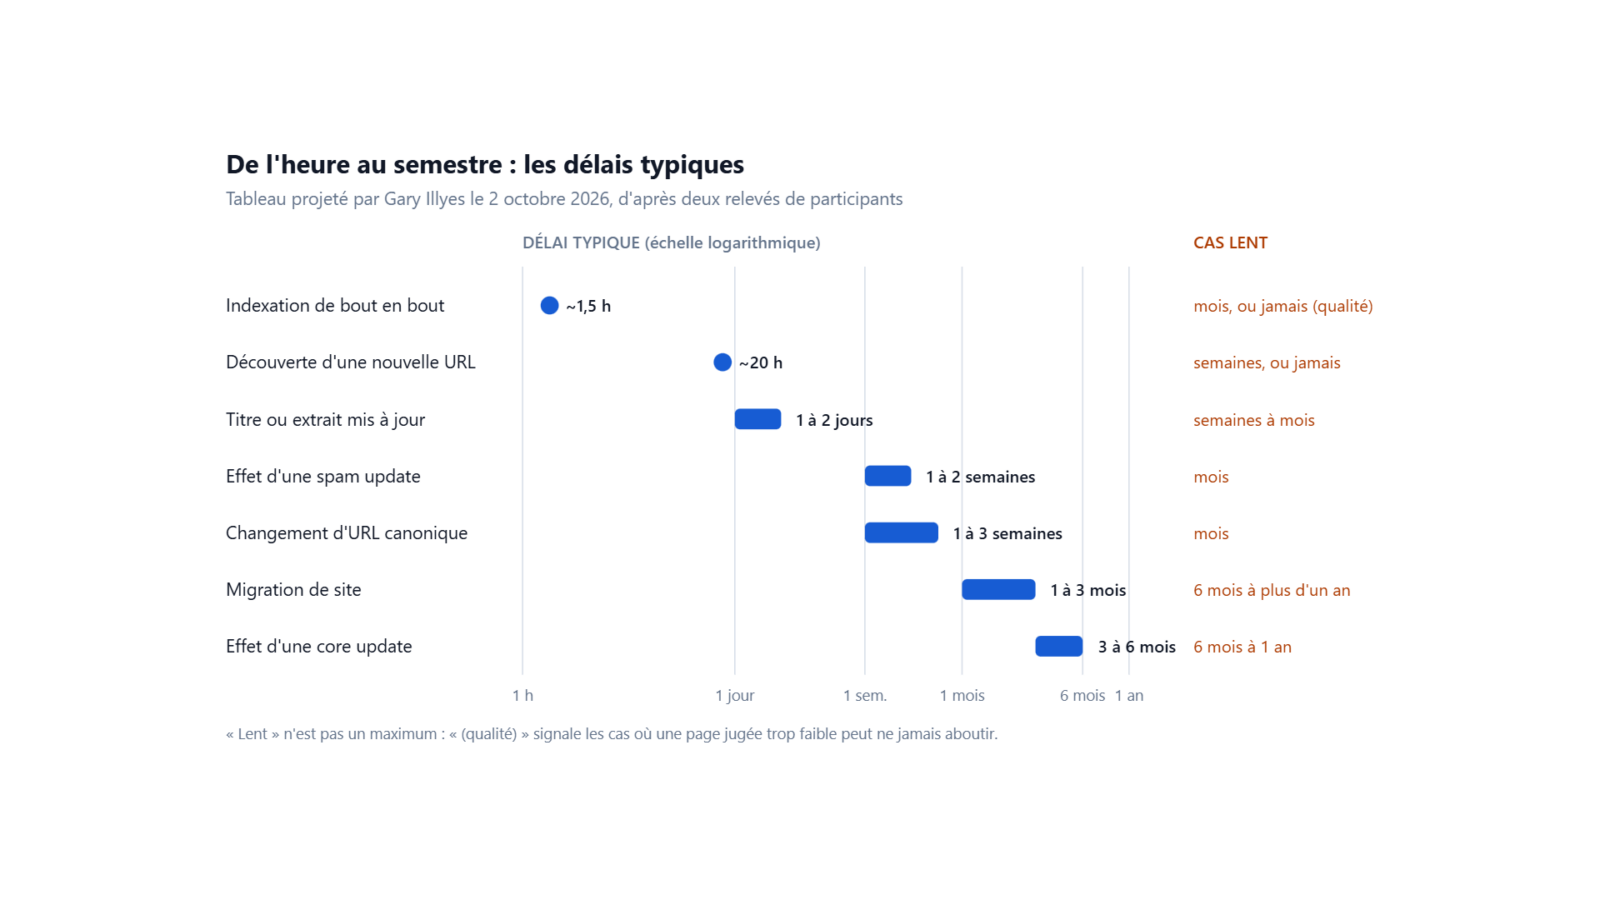
C’est la partie la plus reprise de l’événement. Le 2 octobre, Gary Illyes a projeté un tableau des délais internes : pour chaque opération, une durée « typique » et une durée « lente ». Deux participants l’ont relevé indépendamment : John Campbell (ROAST) et le consultant Neil McCarthy, dont les relevés sont repris par Search Engine Roundtable. Nacho Mascort en confirme une partie. Selon Search Engine Journal, les diapositives n’apparaissaient pas sur la page des événements de Google à la date de son article. Une core update est une mise à jour majeure de l’algorithme, plusieurs fois par an ; une migration est un changement d’adresse ou de structure d’un site entier.
| Opération | Délai typique | Cas lent |
|---|---|---|
| Découverte d’une nouvelle URL | ~20 h | semaines, ou jamais |
| Nouvelle visite d’une URL connue | ~30 jours | semaines, ou jamais |
| Traitement d’un sitemap (la liste d’URL fournie à Google) | ~24 h | jusqu’à 14 jours, ou jamais (qualité) |
| Indexation de bout en bout | ~1,5 h | mois, ou jamais (qualité) |
| Mise à jour des données structurées (les balises qui décrivent la page aux moteurs) | quelques heures à 2 semaines | semaines, ou jamais (qualité) |
| Changement d’URL canonique (la version retenue parmi des doublons) | 1 à 3 semaines | mois |
| Migration de site | 1 à 3 mois | 6 mois à plus d’un an |
| Mise à jour du titre ou de l’extrait | 1 à 2 jours | semaines à mois |
| Levée d’une action manuelle (sanction posée par un humain) | 1 à 2 semaines | 4 à 6 semaines et plus |
| Effet d’une spam update (mise à jour anti-spam) | 1 à 2 semaines | mois |
| Effet d’une core update | 3 à 6 mois | 6 mois à 1 an (prochaine core update) |
Deux lectures s’imposent. La première : la colonne « lente » n’est pas un maximum. Plusieurs lignes se terminent par « jamais », et trois portent la mention « qualité » sur la diapositive : le traitement du sitemap, l’indexation et la mise à jour des données structurées. Pour celles-là, une page ou un site jugé trop faible peut ne jamais aboutir. C’est le mécanisme décrit dans l’article sur le statut « Explorée, actuellement non indexée », et dans la courbe des liens internes relevée sur gameofseo.fr.
La seconde : après une core update, le délai typique pour voir l’effet d’une amélioration est de trois à six mois, et le cas lent renvoie à la core update suivante. La documentation de Google dit la même chose avec plus de nuance : « certaines modifications peuvent prendre effet en quelques jours, mais nos systèmes peuvent mettre plusieurs mois à apprendre et à confirmer que le site dans son ensemble produit désormais des contenus utiles ». Le détail est dans l’article sur les core updates.
Ce que ça change pour un site
Rien de ce qui a été dit à Barcelone n’est une nouvelle règle. Mais plusieurs points passent de l’hypothèse à la déclaration, et ils dessinent des priorités.
- Ne pas construire de version « pour l’IA de Google ». Même robot, même index, mêmes systèmes de qualité. Le guide de Google l’écrit : « il est inutile de créer des fichiers lisibles par machine ou des fichiers textuels d’IA, ou encore d’utiliser des balises ou le format Markdown pour apparaître dans la recherche Google ». Il ajoute qu’un fichier comme
llms.txt(un résumé du site destiné aux modèles d’IA) reste possible pour d’autres services qui l’utilisent. Le raisonnement est développé dans GEO et SEO : ce qui change, ce qui ne change pas. - Vérifier que l’essentiel est dans la page sans attendre un geste du visiteur. Le contenu chargé seulement au clic sur « voir plus » ou au défilement est celui qui risque de manquer. L’outil d’inspection d’URL de la Search Console montre la page telle que Google l’a rendue : c’est là qu’on le vérifie.
- Laisser les extraits et les vignettes larges quand l’objectif est la visibilité, puisque l’éligibilité à un extrait conditionne l’apparition dans les réponses IA — et vérifier dans la Search Console que le site n’en est pas exclu.
- Sur un gros site, traiter la vitesse du serveur comme un sujet d’exploration, pas seulement d’expérience utilisateur : un TTFB lent et des erreurs serveur réduisent la capacité d’exploration. Pour un site qui n’a pas beaucoup de pages changeant rapidement, Google indique que son guide sur le sujet n’est pas nécessaire.
- Passer les gabarits de pages au crible des quatre attributs, type par type plutôt que page par page : fiches produit, catégories, articles. Un gabarit (le modèle commun à toute une série de pages) qui produit du contenu générique à grande échelle se repère plus vite qu’une page faible isolée. C’est une déduction de méthode, pas une consigne de Google, et les quatre attributs sont des critères d’évaluateurs, pas un barème de classement.
- Juger un correctif sur plusieurs mois. Un effet peut apparaître en quelques jours, mais l’absence d’effet au bout de quelques semaines ne prouve rien : le délai typique présenté est de trois à six mois.
Ce qui reste inconnu
Documenté : les dates et le format de l’événement ; le lien entre fonctionnalités IA et systèmes de la Recherche ; le rendu sans interaction ; les facteurs de capacité d’exploration ; la définition du contenu principal et les quatre attributs de qualité ; l’inutilité des fichiers spéciaux pour la recherche Google ; le contenu générique ; les 40 milliards de pages de spam. Dit sur scène, recoupé par deux participants : le rôle de la qualité à la récupération, les propos de Duy Nguyen, le tableau des délais. Dit sur scène, un seul compte rendu : le robot commun à la recherche et à l’IA dans sa formulation exacte, la recommandation de John Mueller sur les directives, les erreurs hreflang, l’absence de robot Discover. Inconnu : le poids de chaque attribut de qualité et les seuils qui font basculer une page vers « jamais ».
Trois limites à garder en tête. Les phrases des intervenants sont reformulées, pas citées, faute de transcription. Plusieurs synthèses circulent qui compilent des comptes rendus sans avoir assisté à l’événement : elles ne sont pas comptées ici comme des témoins. Enfin, certains billets mêlent l’événement à d’autres sources — procès antitrust américain, documents internes de Google divulgués en 2024 — que les intervenants n’ont pas présentées : ces éléments sont exclus ici, et traités dans l’article sur la fuite Google.
| Affirmation | Statut | Source |
|---|---|---|
| L’événement s’est tenu du 30 septembre au 2 octobre 2026 à Barcelone, en anglais | Documenté | Blog Google Search Central, 06/07/2026 |
| Les fonctionnalités d’IA générative reposent sur les systèmes de classement et de qualité de la Recherche | Documenté | Guide IA générative de Google |
| Recherche, Aperçu IA et Mode IA explorés par le même Googlebot | Dit sur scène, un seul compte rendu détaillé | ROAST, jour 1 |
| Gemini aurait un robot distinct | Contredit par la documentation, qui décrit un jeton sans user-agent propre | ROAST, jour 1 ; page Google sur les robots d’exploration |
| La capacité d’exploration baisse avec les erreurs serveur et un temps de réponse lent | Documenté | Page Google sur le budget d’exploration, MàJ 16/09/2026 |
| Le rendu de Google ne fait ni défiler ni cliquer | Documenté | Page Google sur le chargement différé |
| Définition du contenu principal | Documenté | Page Google sur le contenu utile |
| Quatre attributs : effort, originalité, talent ou compétence, exactitude | Documenté, comme critères des évaluateurs | Page Google sur le contenu utile, dernière MàJ 05/10/2026 |
| La qualité tranche entre les pages récupérées, comme un attribut de l’URL | Dit sur scène, recoupé, mécanisme non publié | ROAST, jour 3 ; Nacho Mascort |
| 40 milliards de pages de spam détectées par jour | Documenté | Google, How Search Works |
| Tableau des délais (découverte ~20 h, core update 3 à 6 mois…) | Dit sur scène, recoupé, diapositives non publiées | ROAST, jour 3 ; Neil McCarthy via Search Engine Roundtable ; Nacho Mascort (en partie) |
| Inutile de créer des fichiers spéciaux pour la recherche Google | Documenté | Guide IA générative de Google |
| Définition du contenu générique | Documenté | Guide IA générative de Google |
| Poids des attributs de qualité et seuils du « jamais » | Non documenté | — |
Questions fréquentes
Google a-t-il annoncé une nouveauté à Barcelone ?
Pas au sens d’un lancement. L’événement était un parcours pédagogique sur le fonctionnement du moteur. Les éléments nouveaux sont des précisions — le tableau des délais surtout — et une mise à jour de documentation publiée le 1er octobre, pendant l’événement, pour aligner les pages de Google sur ses présentations.
Faut-il optimiser différemment pour l’Aperçu IA et le Mode IA ?
D’après ce que Google documente, non : les réponses IA s’appuient sur l’index et les systèmes de qualité de la recherche classique. Une page doit d’abord être indexée et éligible à un extrait, et le site ne doit pas en être exclu dans la Search Console. Ce qui fait la différence, c’est un contenu qui n’est pas générique.
Combien de temps pour se rétablir après une core update ?
Trois à six mois en délai typique, jusqu’à la core update suivante dans les cas lents, selon le tableau présenté par Gary Illyes le 2 octobre. La documentation de Google précise que certaines modifications peuvent prendre effet en quelques jours, d’autres plusieurs mois.
L’IA est-elle pénalisée par Google ?
Non, pas en tant que telle. Duy Nguyen a rappelé que la qualité se juge de la même façon pour un contenu humain ou généré. Ce que la page de Google sur le contenu utile classe comme faible effort, c’est la production en masse « sans supervision ni sélection humaines ».
Sources
- Google Search Central, Search Central Deep Dive Europe 2026 : apparemment, nous allons à Barcelone, 06/07/2026 — developers.google.com
- Google Search Central, Dernières mises à jour de la documentation, entrée du 01/10/2026 — developers.google.com
- Google Search Central, Créer des contenus utiles, fiables et people-first, dernière mise à jour 05/10/2026 — developers.google.com
- Google Search Central, Guide Google pour optimiser les fonctionnalités d’IA générative dans la recherche Google, version française du 13/07/2026 — developers.google.com
- Google Search Central, Optimiser votre budget d’exploration, 16/09/2026 — developers.google.com
- Google Search Central, Chargement différé, 18/12/2025 — developers.google.com
- Google Search Central, Mises à jour principales de la recherche Google, 31/12/2025 — developers.google.com
- Google, Robots d’exploration communs de Google — developers.google.com
- Google, How Search Works — Detecting spam — google.com
- John Campbell (ROAST), compte rendu du jour 1, 30/09/2026 — weareroast.com
- John Campbell (ROAST), compte rendu du jour 2, 01/10/2026 — weareroast.com
- John Campbell (ROAST), compte rendu du jour 3, 02/10/2026 — weareroast.com
- Nacho Mascort, Quality at Google: what it is, how it is measured and how long it takes to recover from a core update, 03/10/2026 — nachomascort.com
- Barry Schwartz, Google Search Data On Crawling, Indexing & Serving Timelines, Search Engine Roundtable, 05/10/2026 — seroundtable.com
- Matt G. Southern, Google Shows How Long Crawling, Indexing & Recovery Can Take, Search Engine Journal, 04/10/2026 — searchenginejournal.com