
Documenté : Merriam-Webster a élu slop mot de l’année 2025, et Google écrit que ce qu’il sanctionne, c’est le contenu sans valeur produit en masse, « quelle que soit la manière dont il est créé ». Observé et déduit : le seul travail universitaire qui essaie de mesurer le slop constate que l’accord entre correcteurs professionnels est faible sur l’étiquette globale et correct sur les critères précis ; et le calcul publié plus bas montre qu’un texte accusé par un détecteur d’IA a souvent été écrit par un humain. Inconnu : aucun taux d’erreur de détecteur indépendant, revu par les pairs et mesuré sur du français n’est publié, et Google ne nomme aucun système anti-slop pour son moteur de recherche.
Slop : d’où vient le mot, et ce qu’il désigne
Slop, en anglais, c’est la pâtée qu’on verse dans une auge. Le développeur Simon Willison a popularisé l’usage le 8 mai 2024, en relayant une formule de l’utilisateur @deepfates : « slop is going in the dictionary as the term for unwanted AI generated content » (le slop entre au dictionnaire comme le terme désignant le contenu généré par IA dont personne n’a voulu). Sa propre définition est plus précise : « if it’s mindlessly generated and thrust upon someone who didn’t ask for it, slop is the perfect term for it » (si c’est généré sans réfléchir et imposé à quelqu’un qui n’a rien demandé, slop est le terme parfait).
Merriam-Webster en a fait son mot de l’année 2025 : « digital content of low quality that is produced usually in quantity by means of artificial intelligence » (du contenu numérique de faible qualité, généralement produit en quantité au moyen de l’intelligence artificielle).
Trois éléments, et il faut les trois : faible qualité, en quantité, par une IA. Un texte écrit avec l’aide d’une IA et qui apporte quelque chose n’est pas du slop. Mille pages générées en une nuit pour occuper des requêtes — des recherches tapées dans Google —, si.
Les cinq marqueurs qui trahissent un contenu slop
En septembre 2025, révisé en janvier 2026, quatre chercheurs ont publié Measuring AI « Slop » in Text, un des rares travaux qui essaient de mesurer la chose plutôt que de la dénoncer : 250 textes annotés par trois correcteurs professionnels selon onze critères. Voici les cinq qui parlent le plus à un lecteur non expert.
- La densité d’information est faible. Beaucoup de mots, peu de faits : trois paragraphes pour ce qui tient en une phrase.
- Le texte répond à côté. Il traite le sujet voisin, plus facile, plutôt que la question posée.
- Il se répète et suit un gabarit. Mêmes tournures, même plan que les dix autres articles sur la requête.
- Il est verbeux. Chaque idée arrive précédée d’une mise en bouche et suivie d’un rappel.
- Le ton est uniformément enthousiaste. Aucune réserve, aucun cas où ça ne marche pas, aucune source qui contredit.
Le résultat le plus utile de cette étude n’est pas la grille, c’est l’endroit où les correcteurs se sont accordés. Sur l’étiquette globale « slop / pas slop », l’accord est faible : un kappa — une mesure d’accord où 0 vaut « rien de plus que le hasard » et 1 « accord parfait » — de −0,15 à 0,29. Les auteurs préviennent que ce chiffre est trompeur, « we caution that these scores appear poor due to the low prevalence of the « slop » category » (ces scores paraissent mauvais à cause de la faible fréquence de la catégorie « slop »), et donnent la mesure corrigée : de 0,12 à 0,42. Surtout, l’accord remonte franchement dès qu’on descend au niveau des critères : 0,76 sur la factualité, 0,67 sur les biais.
La leçon est utilisable telle quelle : on s’accorde mal sur « est-ce du slop ? », bien mieux sur « est-ce faux ? ». Jugez critère par critère, jamais à l’étiquette.
Ce que valent les détecteurs de contenu IA
Le réflexe est de coller le texte dans un détecteur. Le problème est arithmétique.
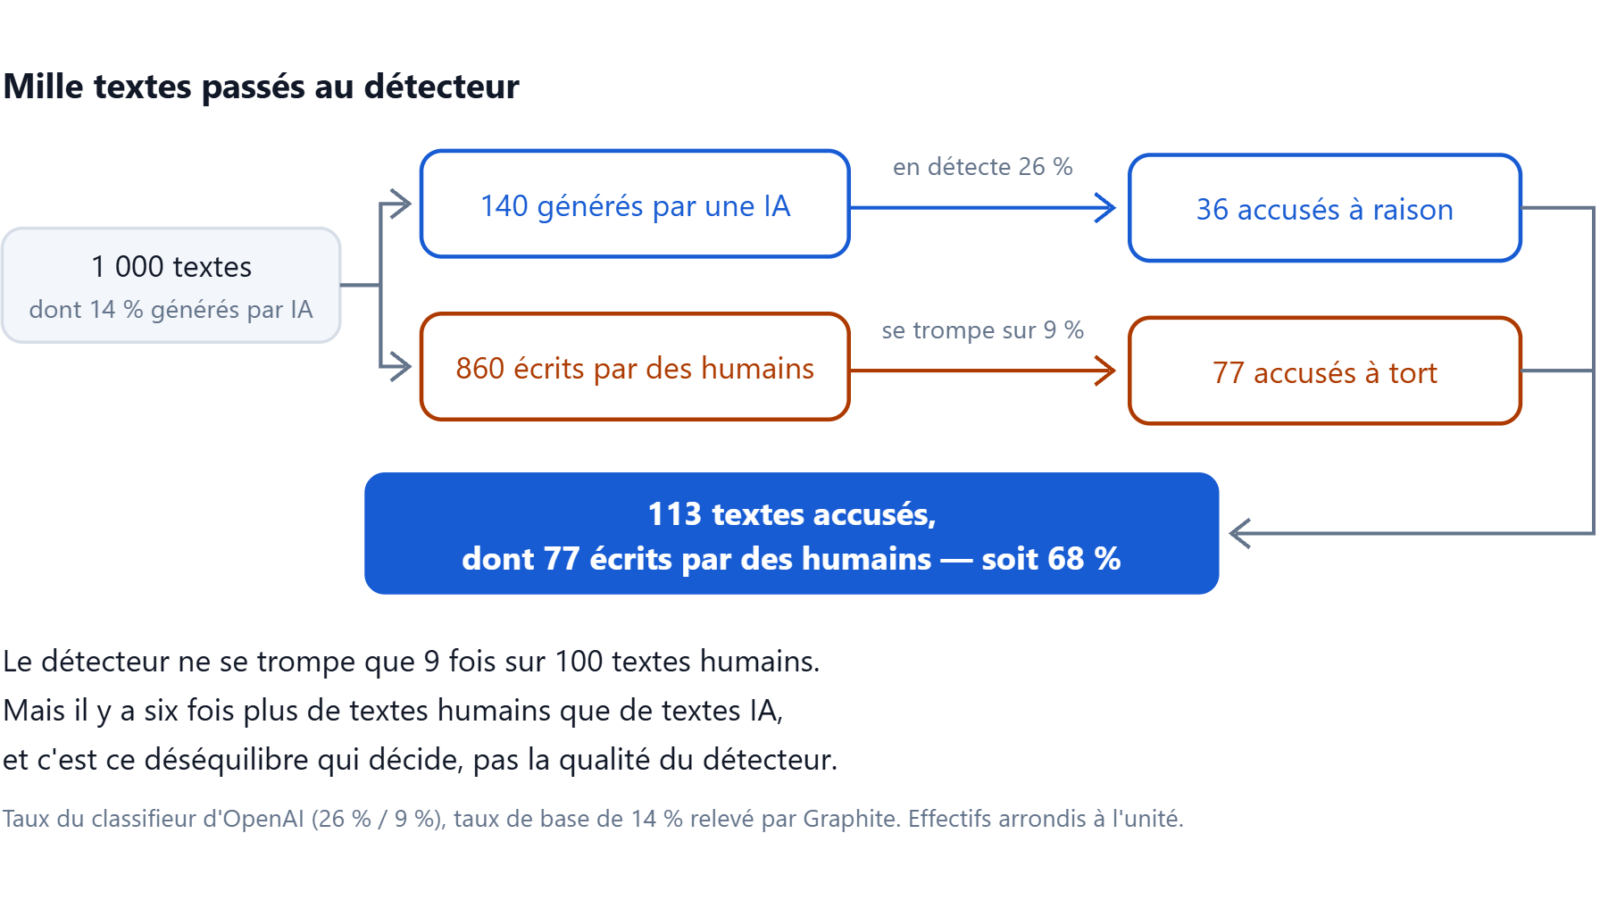
OpenAI a publié le sien — un classifieur, c’est-à-dire un programme qui range un texte dans une catégorie —, puis l’a retiré le 20 juillet 2023 « due to its low rate of accuracy » (en raison de son faible taux d’exactitude) : il repérait 26 % des textes générés par IA et signalait à tort 9 % des textes humains. En 2023, une équipe de Stanford a testé sept détecteurs sur 91 dissertations écrites par des étudiants étrangers passant le TOEFL, un examen d’anglais : 61,22 % de faux positifs en moyenne, et 97,80 % des copies humaines signalées par au moins un détecteur. La même année, une étude revue par les pairs a testé quatorze outils : « all scored below 80 % of accuracy » (aucun n’atteint 80 % d’exactitude), avec des faux positifs allant de 0 % à 50 % selon l’outil.
Relevé propre. Reste la question que se pose vraiment un rédacteur accusé : si un détecteur signale mon texte, quelle est la probabilité qu’un humain l’ait écrit ? Elle se calcule à partir des taux publiés et du taux de base, la proportion réelle de textes IA dans le lot examiné. Script complet, à rejouer :
# P(humain | signale IA) = FPR*(1-p) / ( FPR*(1-p) + TPR*p )
# p = part reelle de textes IA dans le lot ; TPR = taux de detection ;
# FPR = part des textes humains signales a tort.
for nom, tpr, fpr in [
        ("Classifieur d'OpenAI",                0.260, 0.0900),
        ("Surfer, releve Graphite 10/2025",     0.994, 0.0420),
        ("14 outils, 7 detecteurs TOEFL",       1.000, 0.6122)]:
    for p in (0.14, 0.509):
        num = fpr * (1 - p)
        print(nom, p, round(num / (num + tpr * p) * 100, 1))
Toutes les lignes produites par le script, sans sélection. OpenAI désigne son classifieur retiré en 2023, Surfer le détecteur du relevé Graphite d’octobre 2025, 7 détecteurs la moyenne de Liang et ses coauteurs avec la détection fixée à 100 %.
| Détecteur | Détection | Faux positifs | Taux de base | Accusé, mais humain |
|---|---|---|---|---|
| OpenAI | 26,0 % | 9,00 % | 14 % | 68,0 % |
| OpenAI | 26,0 % | 9,00 % | 50,9 % | 25,0 % |
| Surfer | 99,4 % | 4,20 % | 14 % | 20,6 % |
| Surfer | 99,4 % | 4,20 % | 50,9 % | 3,9 % |
| 7 détecteurs | 100 % | 61,22 % | 14 % | 79,0 % |
| 7 détecteurs | 100 % | 61,22 % | 50,9 % | 37,1 % |
Méthode et réserves. Les deux premières lignes de chaque paire prennent leurs deux taux sur une même source : OpenAI pour l’une, le relevé Graphite d’octobre 2025 pour l’autre. La troisième fait exception et le dit : seul son taux de faux positifs est mesuré (Liang et al., 2023), la détection y est fixée à 100 %, l’hypothèse la plus favorable au détecteur. Deux réserves de plus : ce taux de 61,22 % est mesuré sur des copies d’étudiants non anglophones, une population où les détecteurs se trompent plus qu’ailleurs, et il est ici appliqué à un lot d’articles web sans rapport. Les taux de base viennent de deux études Graphite distinctes : 14 % du relevé de juin 2025 sur 31 493 mots-clés dans les résultats de Google, 50,9 % du relevé de mai 2026 sur 55 400 adresses tirées de Common Crawl — une archive publique du web —, point haut du quatrième trimestre 2025. C’est un calcul sur des taux publiés, pas une mesure de terrain, et aucun de ces taux n’a été mesuré sur du français.
Lecture : moins le lot examiné contient de textes IA, plus une accusation est probablement fausse. Sur les articles qui se classent dans Google, où l’IA pèse 14 %, le détecteur qui accuse le moins se trompe deux fois sur trois quand il accuse.
Et pour le français, la situation est pire : les corpus de test publiés — sept langues chez Weber-Wulff et ses coauteurs, onze chez MULTITuDE — ne contiennent pas de français. Le seul chiffre disponible est celui qu’un éditeur publie sur son propre moteur : Compilatio annonce « a false positive rate below 1 % » (moins de 1 % de faux positifs) sur 7 400 textes en 24 langues dont le français, sans détail par langue.
Ce que ça coûte vraiment
Google ne parle pas de « slop ». Sa politique anti-spam nomme la chose abus de contenu à grande échelle et la définit ainsi : « creating large amounts of unoriginal content that provides little to no value to users, no matter how it’s created » (créer de grandes quantités de contenu non original qui n’apporte que peu ou pas de valeur aux utilisateurs, quelle que soit la manière dont il est créé). Le premier exemple donné vise « generative AI tools […] to generate many pages without adding value » (des outils d’IA générative pour générer de nombreuses pages sans apporter de valeur). C’est le même mécanisme que celui décrit dans l’article sur le spam update.
Les six derniers mots de la définition sont ceux qui comptent : no matter how it’s created. La ligne de partage n’est pas l’outil, c’est la valeur. La documentation de Google sur le contenu utile le dit dans l’autre sens : ce contenu « can include automated, AI-generated, and AI-assisted content » (peut inclure du contenu automatisé, généré par IA ou assisté par IA).
Côté moteurs, le relevé Graphite de juin 2025 donne l’ordre de grandeur : 86 % des articles qui se classent dans Google et 82 % de ceux que citent ChatGPT et Perplexity sont écrits par des humains, et 7 % seulement des articles en première position sont générés par IA — alors que sur le web publié, la part de contenu majoritairement généré par IA tourne autour de 50 % (49,6 % au premier trimestre 2025, 50,9 % au quatrième, 49,9 % au premier trimestre 2026). Le slop se publie beaucoup et se classe peu.
Un mot enfin sur le papier « anti-slop » de Google qui circule depuis quelques mois. Il existe — Scalable Detection of Adversarial Synthetic Slop and Coordinated Media Abuse, signé par quatre auteurs de Google — mais il porte sur les « online video platforms » (plateformes de vidéo en ligne). Il ne mentionne pas le moteur de recherche, ce qui n’est pas la même chose que de l’exclure.
Six contrôles avant de publier
- Un fait vérifiable par paragraphe. Un paragraphe sans chiffre, sans date, sans nom ni exemple se supprime en général sans perte. C’est une heuristique, pas un quota : Google précise de son côté ne pas avoir de longueur préférée.
- Une source primaire par affirmation forte. Pas un article qui cite un article : la page de l’éditeur, l’étude, le document officiel.
- Une chose introuvable ailleurs. Un calcul refait soi-même, un relevé daté, un contre-exemple.
- Une réserve explicite. Ce que la source ne dit pas, le cas où le conseil ne marche pas.
- Le test de la suppression. Retirer chaque phrase l’une après l’autre : si le sens ne bouge pas, c’était du remplissage.
- Une relecture humaine. C’est le cœur de la formule de Willison : le slop, c’est du contenu généré et non relu qu’on impose à quelqu’un.
Ce qui est documenté, déduit ou inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Slop = contenu numérique de faible qualité, produit en quantité par IA | Documenté | Merriam-Webster, mot de l’année 2025 |
| Google sanctionne le contenu sans valeur produit en masse « quelle que soit la manière dont il est créé » | Documenté | Politiques anti-spam de Google |
| Le contenu utile peut être généré ou assisté par IA | Documenté | Contenu utile, documentation Google |
| Accord entre correcteurs : kappa −0,15 à 0,29 sur l’étiquette globale, 0,76 sur la factualité | Documenté | Shaib et al., 09/2025, révisé 01/2026 |
| Classifieur d’OpenAI : 26 % de détection, 9 % de faux positifs, retiré le 20/07/2023 | Documenté | OpenAI |
| Quatorze outils testés, aucun au-dessus de 80 % d’exactitude, faux positifs de 0 % à 50 % | Documenté | Weber-Wulff et al., 2023 |
| 61,22 % de faux positifs moyens de sept détecteurs sur 91 copies TOEFL humaines | Documenté | Liang et al., 2023 |
| 86 % des articles classés dans Google sont écrits par des humains | Documenté | Graphite, relevé de juin 2025 |
| Le papier anti-slop de Google porte sur les plateformes de vidéo en ligne | Documenté | Mathur et al., Google |
| Ce papier ne s’applique pas au moteur de recherche | Déduit | Absence de mention, pas exclusion écrite |
| Un texte accusé par le classifieur d’OpenAI est humain dans 68 % des cas à un taux de base de 14 % | Déduit | Calcul reproductible, script ci-dessus |
| « Un texte écrit avec une IA est du slop » | Faux | Contredit par la documentation Google |
| « Un détecteur prouve qu’un texte a été généré » | Faux | Contredit par les taux ci-dessus |
| Aucun taux d’erreur indépendant, revu par les pairs et mesuré sur du français | Non documenté | Corpus sans français chez Weber-Wulff et MULTITuDE ; Compilatio ne publie pas de détail par langue |
| Google ne nomme aucun système anti-slop pour la recherche | Non documenté | La page anti-spam ne décrit que des « automated systems » (systèmes automatisés) |
| Les grilles de marqueurs de forme utilisées en agence (tirets, tournures types) | Convention | Usage professionnel, jamais mesuré |
Questions fréquentes
Écrire un article avec ChatGPT, est-ce du slop ? Non, pas en soi. La définition de Merriam-Webster comme la politique de Google portent sur la valeur et le volume, pas sur l’outil. Un article assisté par IA, relu et sourcé, ne relève ni de l’une ni de l’autre. Le détail de la fabrication du texte est expliqué dans l’article sur la façon dont ChatGPT génère une réponse.
Un détecteur de contenu IA sert-il à quelque chose ? À se poser une question, pas à trancher. Le tableau ci-dessus montre qu’à un taux de base réaliste, une accusation est souvent fausse ; quatorze outils testés en 2023 plafonnaient tous sous 80 % d’exactitude, et le seul détecteur dont l’éditeur ait publié ses propres taux a été retiré pour cette raison.
Google déclasse-t-il un site parce qu’il publie du contenu IA ? Rien dans sa documentation ne le dit. Ce qui y est décrit, c’est la sanction de l’abus de contenu à grande échelle : de nombreuses pages sans valeur, publiées pour occuper des requêtes. La façon dont Google juge cette valeur est détaillée dans l’article sur les quality raters. Repère pour la France : AI Overviews et AI Mode y sont déployés depuis le 22 juillet 2026.
Sources vérifiées et chiffres arrêtés au 5 septembre 2026.
Sources
- Merriam-Webster — Word of the Year 2025 — merriam-webster.com
- Simon Willison, 8 mai 2024 — Slop is the new name for unwanted AI-generated content — simonwillison.net
- Google — Spam policies for Google web search — developers.google.com
- Google — Creating helpful, reliable, people-first content — developers.google.com
- C. Shaib, T. Chakrabarty, D. Garcia-Olano, B. C. Wallace — Measuring AI « Slop » in Text, arXiv:2509.19163, septembre 2025, révisé le 24 janvier 2026 — arxiv.org
- OpenAI — New AI classifier for indicating AI-written text, retiré le 20 juillet 2023 — openai.com
- W. Liang, M. Yuksekgonul, Y. Mao, E. Wu, J. Zou — GPT detectors are biased against non-native English writers, arXiv:2304.02819 — arxiv.org
- D. Weber-Wulff et coll. — Testing of detection tools for AI-generated text, International Journal for Educational Integrity, 25 décembre 2023 — link.springer.com
- Graphite, juin 2025 — AI content in search and LLMs — graphite.io
- Graphite, mai 2026 — AI now writes as many online articles as humans do — graphite.io
- Compilatio — How reliable is the Compilatio AI detector? — support.compilatio.net
- A. Mathur, C. Liu, K. Tan, Y. Liu (Google) — Scalable Detection of Adversarial Synthetic Slop and Coordinated Media Abuse — storage.googleapis.com