
Vous lisez depuis quelques jours que Google a « refondu » le query fan-out — la technique qui découpe votre question en plusieurs recherches invisibles — avec un modèle appelé R4T-Diffusion, et que le Mode IA en serait transformé. Faut-il revoir vos pages ? Cet article part du billet de Google Research du 15 septembre 2026 et du papier scientifique qui le porte, et y sépare ce que Google a réellement montré de ce que la presse SEO en a tiré, pour arriver à ce qu’un site peut raisonnablement en retenir.
Ce que Google a publié, et ce qu’il n’a pas dit
Le 15 septembre 2026, le blog de Google Research a publié un billet signé par deux de ses chercheurs, Pengcheng Jiang et Judith Yue Li, sur une méthode baptisée Retrieve-for-Train, abrégée R4T. Le papier scientifique correspondant date du 6 mars 2026 sur arXiv (le dépôt public de préimpressions — des articles de recherche diffusés avant ou en parallèle d’une publication) et a été présenté à ICML 2026, une grande conférence d’apprentissage automatique tenue à Séoul du 6 au 11 juillet. Ses auteurs viennent de Google Research et de l’université de l’Illinois à Urbana-Champaign.
Le point de départ est le query fan-out, que Google documente déjà pour ses produits grand public. Sa page d’aide sur les fonctionnalités d’IA l’écrit en français : « Les Aperçus l’IA [sic] et le Mode IA peuvent utiliser une technique de « distribution ramifiée de requêtes » (qui consiste à effectuer plusieurs recherches associées sur des sous-thèmes et des sources de données) pour développer une réponse. » Le mécanisme est détaillé dans notre article sur le query fan-out et les recherches invisibles.
Ce que ni le billet ni le papier ne disent : que R4T tourne dans la recherche Google, dans le Mode IA ou dans les Aperçus IA. Le billet parle de recherche « production-ready » (prête pour la production), ce qui décrit une capacité, pas un déploiement. Roger Montti, dans Search Engine Journal le 24 septembre, en a tiré une hypothèse qu’il présente lui-même comme telle : « it could be inferred that it’s announced at this time because it’s been deployed. But we don’t know for certain. » (on pourrait en déduire que c’est annoncé maintenant parce que c’est déployé, mais on n’en est pas certain). Son indice est le délai de six mois entre le papier et le billet. Une explication plus banale existe : le billet présente le papier comme « our ICML 2026 paper » (notre papier d’ICML 2026), et ce type de billet suit souvent la conférence. Search Engine Watch, le 29 septembre, s’en tient à « deployment in Google Search remains unconfirmed » (le déploiement dans la recherche Google n’est pas confirmé).
Le problème : un fan-out qui tourne en rond, et qui coûte du temps
Google Research part de deux défauts du fan-out confié à un LLM (grand modèle de langage, du type de celui qui fait tourner Gemini ou ChatGPT) utilisé sans préparation particulière.
Le premier porte un nom dans le billet : l’effondrement paraphrastique. Au lieu d’explorer des facettes différentes d’une demande, le modèle produit des variantes de la même phrase. L’exemple donné est celui d’une recherche « Bohemian festival style » (style bohème de festival) : un modèle standard « might lazily generate « bohemian festival fashion » and « bohemian festival clothes » » (pourrait générer paresseusement « mode bohème de festival » et « vêtements bohèmes de festival »), et passer à côté de ce qu’un expert chercherait — vestes à franges, robes au crochet, bottes en daim. Dix sous-requêtes qui se ressemblent ramènent, pour l’essentiel, les mêmes résultats.
Le second défaut est la latence, c’est-à-dire le temps d’attente. Un LLM écrit de façon autorégressive : mot après mot, chaque mot dépendant des précédents. Pour bien découper une demande, il « réfléchit » d’abord, en générant des centaines de mots intermédiaires avant d’écrire ses sous-requêtes. Le billet en conclut que cette architecture crée un plancher de temps de réponse « fundamentally at odds with the sub-second response times required by a production search bar » (fondamentalement incompatible avec les réponses en moins d’une seconde qu’exige une barre de recherche en production).
Comment R4T s’y prend : apprendre une fois, répondre en une passe
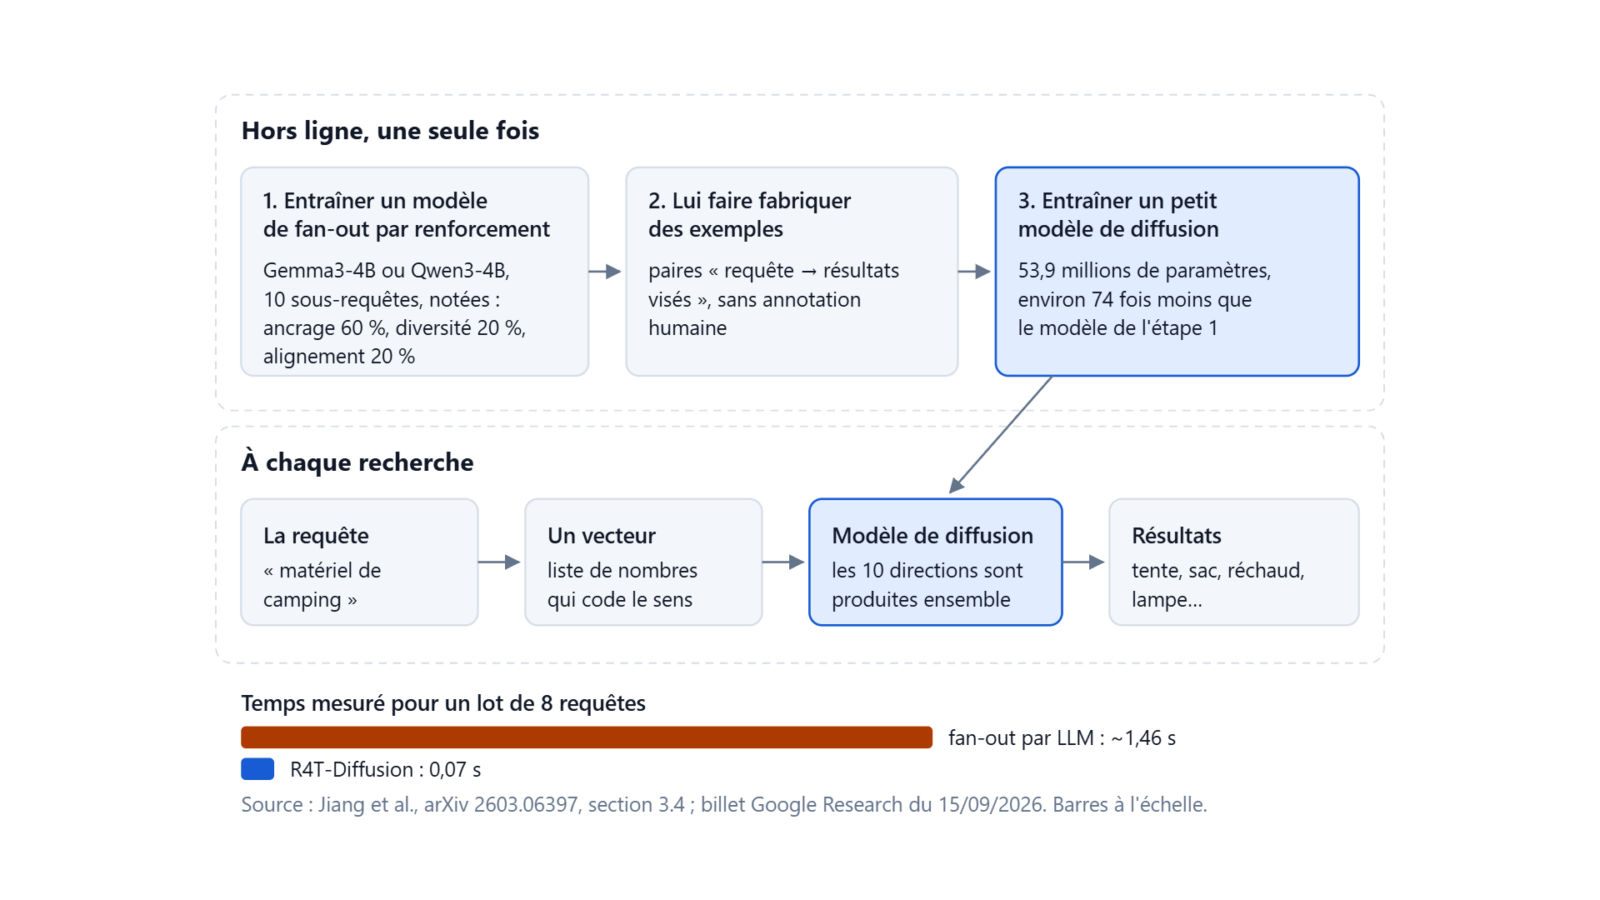
L’idée de R4T est de déplacer le travail coûteux. Au lieu de faire réfléchir un gros modèle à chaque recherche, on lui fait faire ses exercices une fois pour toutes, hors ligne, puis on transmet ce qu’il a appris à un modèle beaucoup plus petit et plus rapide. Trois étapes :
- Entraîner un modèle de fan-out par renforcement. L’apprentissage par renforcement consiste à récompenser le modèle quand il fait bien, sans lui montrer d’exemple corrigé. Les chercheurs partent de modèles ouverts de 4 milliards de paramètres — les réglages internes qu’un modèle apprend, un indicateur de sa taille — (Gemma3-4B de Google et Qwen3-4B d’Alibaba), chargés de produire exactement 10 sous-requêtes par recherche.
- Lui faire fabriquer des exemples. Une fois entraîné, ce modèle génère des paires « requête → ensemble de résultats visés », sans aucune annotation humaine.
- Entraîner un petit modèle de diffusion sur ces exemples. Un modèle de diffusion est le type de modèle utilisé par les générateurs d’images : il part d’un bruit aléatoire et le transforme progressivement en résultat. Celui de R4T compte 53,9 millions de paramètres, soit environ 74 fois moins que les modèles de 4 milliards de l’étape 1. Il ne produit pas de mots : il transforme directement la requête en une série de vecteurs (des listes de nombres qui représentent un sens, expliquées dans notre article sur les embeddings), tous en même temps.
Tout repose sur la récompense de l’étape 1, qui juge l’ensemble des sous-requêtes et pas chacune isolément. Elle combine trois critères, avec des poids publiés dans le papier :
- l’ancrage (60 % du poids) : chaque sous-requête doit tomber près d’un élément qui existe réellement dans la base. Le billet le formule ainsi : « ensuring every generated sub-query corresponds to a real, retrievable item in the database » (garantir que chaque sous-requête correspond à un élément réel et récupérable de la base) ;
- la diversité (20 %) : mesurée par le Vendi Score, un indicateur statistique qui augmente quand les éléments d’un ensemble se ressemblent moins ;
- l’alignement (20 %) : chaque sous-requête doit rester proche de la demande d’origine, pour éviter la dérive hors sujet.
Les trois se tiennent mutuellement. Le billet décrit ce qui arrive quand on en retire un : sans diversité, le modèle optimisé sur le seul ancrage triche en générant des chaînes absurdes, comme « line ending line ending », qui tombent mathématiquement près d’un élément de la base ; avec l’alignement mais sans diversité, il retombe dans les paraphrases de la demande.
Ce que montrent les chiffres, et sur quel terrain
Le gain de qualité est net, sur le terrain où il a été mesuré. Dans le tableau 1 du papier, sur la tâche ouverte (des demandes larges sans « bonne réponse » unique, notées sur l’ancrage, la diversité et l’alignement), avec Gemma3-4B et le jeu de données de mode Polyvore :
| Méthode | Score moyen (Polyvore) | Ancrage | Diversité |
|---|---|---|---|
| Sans fan-out (recherche directe) | 26,1 | 22,4 | 34,4 |
| Fan-out sans entraînement | 38,5 | 28,4 | 56,0 |
| Best-of-N (meilleur de plusieurs tirages) | 40,9 | 28,9 | 61,0 |
| R4T, gros modèle entraîné | 49,1 | 30,8 | 76,8 |
| R4T-Diffusion, petit modèle | non publié | non publié | 74,3 |
Trois lectures, qu’il ne faut pas fusionner.
Le petit modèle rapide ne fait pas mieux que le gros modèle dont il apprend. Sa diversité (74,3 ± 3,4 contre 76,8 ± 2,7) et son alignement (37,6 ± 2,8 contre 39,8 ± 2,3) sont légèrement inférieurs, dans les marges d’erreur publiées. Surtout, le papier ne lui donne ni score d’ancrage ni score moyen — alors que l’ancrage est le critère qui pèse 60 % de la récompense. C’est pourtant la version rapide que le billet présente comme « production-ready ».
Le gain de vitesse dépend du volume traité. La section 3.4 du papier donne des temps mesurés sur des lots de requêtes traitées ensemble :
| Taille du lot | Fan-out par LLM | R4T-Diffusion | Rapport |
|---|---|---|---|
| 8 requêtes | ~1,46 s | 0,07 s | ~20 fois |
| 1 024 requêtes | près de 50 s | 4,21 s | ~12 fois |
Les « 50 secondes » souvent reprises portent donc sur 1 024 requêtes à la fois, soit environ 49 millisecondes par requête : aucun internaute n’attend 50 secondes. Le chiffre parlant pour un utilisateur est celui du petit lot, 1,46 s contre 0,07 s.
Le terrain n’est pas le web. Les deux jeux de données sont un catalogue de tenues de mode composées par des internautes (Polyvore, 21 888 collections et 142 472 articles) et un jeu de listes de lecture musicales qualifié de « proprietary industrial dataset » (jeu de données industriel propriétaire). Les auteurs signalent eux-mêmes en annexe qu’une partie de l’évaluation repose sur un LLM utilisé comme juge — un modèle chargé de noter les résultats à la place d’humains —, avec des biais possibles, et que l’étape d’entraînement peut coûter cher pour une base « extremely large or frequently changing » (extrêmement grande ou qui change souvent). L’index du web coche les deux cases.
Ce que ça change pour un site
Rien d’officiel, puisque rien n’est annoncé pour la recherche Google. Ce qui suit est déduit de la méthode, en supposant qu’un système de ce type soit un jour appliqué au fan-out du Mode IA.
Les sous-requêtes chercheraient des facettes, pas des synonymes. Un fan-out récompensé sur la diversité ira vers des aspects complémentaires d’une demande large — l’exemple de Google pour « matériel de camping » est une tente, un sac de couchage, un réchaud et une lampe frontale. Pour un site, cela renforce une logique déjà valable en SEO classique : une page par facette réelle d’un sujet, reliées entre elles, plutôt que dix pages qui reformulent la même intention. C’est le principe d’un maillage interne organisé par thème. Il n’y a là aucune optimisation nouvelle à inventer.
L’ancrage favorise ce qui existe déjà dans l’index (la base des pages explorées et stockées par le moteur). Le critère qui pèse le plus pousse les sous-requêtes vers des contenus réellement présents dans la base. Sur un catalogue, un produit absent ou mal décrit n’attire pas de sous-requête. Transposé au web, une facette que personne ne couvre risque d’être moins explorée, mais c’est l’extrapolation la plus fragile de cet article : le papier ne teste qu’une base fermée.
Les sous-requêtes ne seraient plus des mots. Dans la version diffusion, le modèle produit des vecteurs et non des requêtes rédigées. Des outils comme le rapport de Bing qui montre les requêtes que l’IA fabrique reposent sur des sous-requêtes écrites. Si un moteur adoptait ce type d’architecture, il n’y aurait plus de liste de sous-requêtes à afficher.
Le site principal du blog avait abordé la question dans une FAQ sur le fan-out en GEO ; la recommandation de couvrir les facettes d’une intention reste la même.
Questions fréquentes
R4T-Diffusion est-il utilisé dans le Mode IA de Google ?
On ne sait pas. Le billet de Google Research et le papier ne mentionnent ni le Mode IA ni les Aperçus IA, et les tests portent sur la mode et la musique. L’idée d’un déploiement vient d’une déduction de Search Engine Journal, que son auteur qualifie lui-même d’incertaine.
Faut-il modifier ses pages à cause de R4T ?
Pas spécifiquement. Si la méthode était adoptée, elle favoriserait les contenus qui couvrent des facettes distinctes d’un sujet, ce qui correspond déjà aux bonnes pratiques de structure et de maillage.
Pourquoi la presse parle-t-elle de 50 secondes ?
C’est le temps mis par le fan-out classique pour traiter 1 024 requêtes ensemble dans l’expérience du papier, soit environ 49 millisecondes par requête. Sur un lot de 8 requêtes, il met environ 1,46 s, contre 0,07 s pour R4T-Diffusion.
Qu’est-ce que l’effondrement paraphrastique ?
C’est le nom donné par Google Research au défaut d’un modèle qui, chargé de découper une demande en sous-requêtes, produit des variantes de la même phrase au lieu d’explorer des aspects différents. Les résultats récupérés se répètent alors.
Ce qui est documenté, déduit ou inconnu
État des connaissances au 2 octobre 2026 : à revoir si Google annonce un déploiement.
Documenté : la méthode, ses trois étapes, ses trois critères et ses mesures viennent du billet de Google Research du 15 septembre 2026 et du papier arXiv du 6 mars 2026 ; l’usage du fan-out par le Mode IA vient de la documentation de Google. Déduit : les conséquences pour un site, qui supposent un déploiement non annoncé et une transposition d’un catalogue fermé à l’index du web. Inconnu : si, où et quand R4T est utilisé dans les produits Google.
| Affirmation | Statut | Source |
|---|---|---|
| Le Mode IA et les Aperçus IA peuvent utiliser le query fan-out | Documenté | Google Search Central, page « Fonctionnalités d’IA » |
| R4T entraîne un modèle de fan-out par renforcement, puis transmet ce qu’il a appris à un modèle de diffusion de 53,9 millions de paramètres | Documenté | Billet Google Research, 15/09/2026 |
| La récompense combine ancrage, diversité (Vendi Score) et alignement | Documenté | Billet Google Research ; papier, poids 0,6 / 0,2 / 0,2 |
| Le fan-out par diffusion est 12 à 20 fois plus rapide | Documenté, mesuré sur lots de 8 à 1 024 requêtes | Papier, section 3.4 |
| R4T-Diffusion ne dépasse pas le gros modèle qu’il imite, et son ancrage n’est pas publié | Documenté (diversité 74,3 ± 3,4 contre 76,8 ± 2,7 sur Polyvore avec Gemma3-4B) | Papier, tableau 1 |
| Les tests portent sur la mode et la musique, pas sur le web | Documenté | Billet Google Research ; papier |
| R4T est déployé dans la recherche Google | Inconnu, hypothèse de presse | Search Engine Journal, 24/09/2026 |
| Un fan-out de ce type privilégierait les pages couvrant des facettes distinctes | Déduit | Critère de diversité du papier |
| Les sous-requêtes ne seraient plus observables sous forme de texte | Déduit | Étape 3 : sortie en vecteurs |
Sources
- Google Research, « Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train », 15/09/2026 — research.google
- Jiang, Li, Ryu et al., « Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion », arXiv 2603.06397, 06/03/2026 — arxiv.org
- Google Search Central, « Fonctionnalités d’IA et votre site Web », mise à jour du 31/12/2025 (version française) — developers.google.com
- Roger Montti, « Google Announces New Query Fan-Out Framework: R4T-Diffusion », Search Engine Journal, 24/09/2026 — searchenginejournal.com
- Radu Tyrsina, « Google unveils a faster way to power query fan-out », Search Engine Watch, 29/09/2026 — searchenginewatch.com
- ICML, annonce des dates d’ICML 2026 (Séoul, 6-11 juillet 2026) — icml.cc