
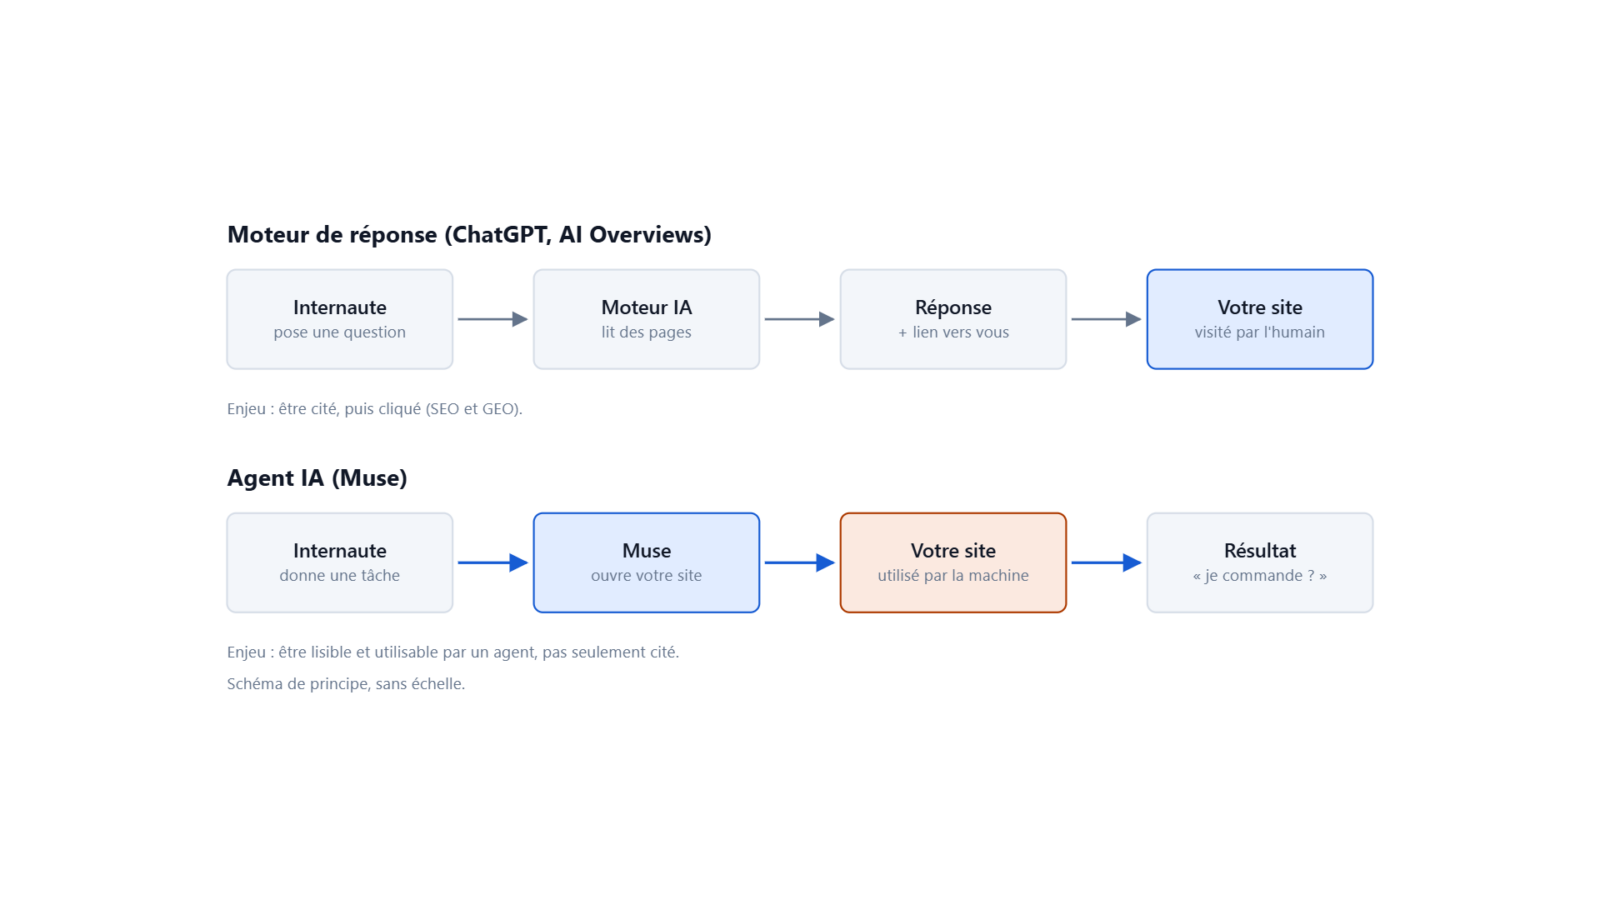
Vous avez passé deux ans à apprendre à vous faire citer par ChatGPT et les AI Overviews. Et voilà qu’arrive, en tête de l’App Store américain, une IA qui ne cite pas votre page : elle l’ouvre, clique sur vos boutons et remplit votre panier à la place de votre visiteur. Muse, l’agent de Meta, n’est pas disponible en France. Cet article s’appuie sur ce que Meta a publié sur son fonctionnement et sur le premier bras de fer avec Amazon, pour dire ce que ça change concrètement, et ce qui se prépare dès maintenant.
Muse, c’est quoi : un agent, pas un moteur de réponse
Meta a lancé Muse le 8 septembre 2026 aux États-Unis ; selon TechCrunch, il est aujourd’hui disponible aux États-Unis et au Canada. C’est un agent IA — un programme qui ne se contente pas de répondre, mais qui exécute des tâches : envoyer un courriel, réserver un voyage, remplir un formulaire, acheter. Meta le décrit comme un assistant qui « proactively helps with people’s goals » (aide de façon proactive les gens à atteindre leurs objectifs).
Le succès est immédiat. Selon les données Sensor Tower reprises par TechCrunch, l’application dépassait 3,4 millions de téléchargements le 25 septembre, et elle occupe la première place de l’App Store américain depuis le 18 septembre. Muse fonctionne avec Muse Spark, le modèle maison de Meta.
La différence avec ChatGPT ou les AI Overviews tient en une phrase. Un moteur de réponse lit des pages, en extrait une réponse et, au mieux, affiche un lien vers vous : c’est tout l’objet du GEO (Generative Engine Optimization, l’optimisation pour être cité par les IA). Un agent, lui, ne s’arrête pas à la réponse. Il va sur votre site et y fait ce que l’internaute aurait fait.
Pour un site marchand, la conséquence est directe : le visiteur humain ne voit plus votre page. Il voit le résultat que l’agent lui rapporte — « j’ai trouvé cette chemise à 49 €, je la commande ? ». Votre fiche produit n’est plus lue par une personne mais par une machine qui décide pour elle.
Comment Muse lit votre site
Meta a publié, le jour du lancement, un billet technique sur la sécurité de Muse. C’est la source la plus précise disponible, et trois phrases y intéressent directement le référencement.
Muse utilise un vrai navigateur. « Muse has a real up-to-date Chromium based browser running behind a virtualization layer » (Muse dispose d’un vrai navigateur à jour, basé sur Chromium, qui tourne derrière une couche de virtualisation). Chromium est le moteur de Google Chrome. Concrètement, Muse charge vos pages comme un internaute, dans une machine virtuelle — un ordinateur simulé, hébergé chez Meta — attribuée à chaque utilisateur. Le contenu affiché par JavaScript (le langage qui fait fonctionner les éléments dynamiques d’une page) est donc chargé comme chez un humain.
Muse ne lit pas votre code, il lit la structure accessible de la page. « The sub-agent, which drives the Browser, sees an accessibility tree snapshot of the page — not the raw DOM » (le sous-agent qui pilote le navigateur voit un instantané de l’arbre d’accessibilité de la page, pas le DOM brut). Le DOM est la représentation complète de la page par le navigateur. L’arbre d’accessibilité en est une version simplifiée, celle qu’utilisent les lecteurs d’écran des personnes malvoyantes : les titres, les liens, les boutons, les champs de formulaire, chacun avec son nom (le texte qui le désigne) et son rôle (bouton, lien, case à cocher). Un bouton dessiné en image sans libellé, un champ « taille » sans étiquette, un menu fait de simples blocs sans rôle déclaré : ce qui est flou pour un lecteur d’écran l’est aussi, en toute logique, pour Muse.
Muse passe pour vous. « When Muse browses the internet, it will appear as your activity » (quand Muse navigue sur internet, cela apparaît comme votre activité). Meta donne l’exemple d’une chemise achetée par Muse sur le site d’un créateur, qui pourra ensuite recibler l’internaute sur Instagram.
Muse ne passe pas que par le navigateur. D’après les partenariats annoncés le 23 septembre à Meta Connect, la conférence annuelle de Meta, il accède aussi au catalogue de produits de Shopify, et pourra se connecter aux applications d’enseignes comme Best Buy, Gap, Sephora, Walmart ou Wayfair. Une porte d’entrée décrite par Meta lui-même — le navigateur —, deux annoncées — le catalogue Shopify et les applications d’enseignes —, et une quatrième dont on ne sait rien : la recherche sur le web.
Ce que Meta ne publie pas, en revanche, c’est comment Muse choisit : ni la façon dont il cherche une page sur le web, ni la façon dont il classe deux produits concurrents. Meta possède bien un robot d’indexation, Meta-WebIndexer, présenté comme servant à « improve Meta AI search result quality » (améliorer la qualité des résultats de recherche de Meta AI). Mais aucune page de Meta ne dit que Muse s’appuie sur cet index. La page d’aide que Meta consacre à la navigation de Muse décrit ce qu’il fait (prendre des rendez-vous, acheter, remplir des formulaires, surveiller une baisse de prix) et précise qu’il peut accepter les cookies essentiels des sites visités, mais ne dit rien de la façon dont il s’identifie auprès d’eux.
Pourquoi le robots.txt ne suffit pas face à Muse
Le robots.txt est le fichier, placé à la racine d’un site, qui indique aux robots d’exploration ce qu’ils ont le droit de visiter. Il fonctionne par nom : chaque robot se présente avec un user-agent (sa carte d’identité technique), et le fichier autorise ou interdit chaque nom.
Muse ne figure pas parmi les robots que Meta documente. Et puisqu’il « apparaît comme votre activité », il se présente comme le navigateur d’un internaute. Un robots.txt n’a donc, a priori, aucun nom à bloquer. Meta écrit d’ailleurs, à propos de son robot de récupération à la demande, que « the Meta-ExternalFetcher crawler may bypass robots.txt because it performs fetches that were requested by the user » (le robot Meta-ExternalFetcher peut contourner le robots.txt, parce qu’il effectue des récupérations demandées par l’utilisateur). La même page lui attribue un rôle qui consiste notamment à « helping AI navigate websites to complete tasks for users » (aider l’IA à naviguer sur les sites pour accomplir des tâches pour les utilisateurs) — sans nommer Muse. Google tient le même raisonnement pour ses propres récupérations déclenchées par un utilisateur.
Amazon en a fait la démonstration douze jours après le lancement. Le 20 septembre, les utilisateurs de Muse ont vu s’afficher ce message : « Continued access by an unauthorized AI agent violates Amazon’s Conditions of Use » (la poursuite de l’accès par un agent IA non autorisé enfreint les conditions d’utilisation d’Amazon). Amazon n’a pas bloqué Muse par un fichier technique, mais par ses conditions d’utilisation, en expliquant que les applications qui achètent pour le compte de clients « should operate openly » (devraient opérer à visage découvert).
Amazon n’est pas le seul à fermer la porte, mais il est l’un des rares à l’écrire. Un relevé publié le 25 septembre par Charlie Major, dans sa lettre Major Matters, a interrogé 92 des plus grands distributeurs américains. Sur les 63 qui ont laissé lire leur robots.txt, seuls 2 y bloquent un agent déclenché par un utilisateur — Amazon est l’un des deux. Mais 42 sur 92 refusent de montrer leur page d’accueil à un agent : le blocage se fait au niveau du réseau (pare-feu, outils de gestion des robots), sans règle publiée. D’où sa conclusion : « Amazon’s block is not the exception » (le blocage d’Amazon n’est pas l’exception). Le relevé est d’un seul auteur, sur une seule journée : c’est un ordre de grandeur, pas une statistique.
Ce que ça change pour le SEO et le GEO
Muse ne remplace pas le référencement. Il en déplace une partie. Trois changements se dessinent, tous déduits de ce que Meta publie, aucun encore mesuré sur Muse lui-même.
Être lisible par une machine qui agit, et plus seulement par une machine qui lit. Le SEO optimise une page pour qu’un moteur la comprenne et la classe ; le GEO, pour qu’une IA la cite. Avec un agent, il faut en plus qu’une machine puisse s’en servir : trouver le prix, choisir la taille, cliquer sur « ajouter au panier ». L’accessibilité, longtemps traitée comme une obligation légale à part, devient une condition de visibilité. Une étude publiée le 24 septembre par AudioEye, éditeur de solutions d’accessibilité, va dans ce sens : sur le site le moins accessible de son test, des agents IA n’ont accompli que 31 % des tâches demandées, contre 96 % sur une version accessible du même site. Deux réserves : l’éditeur vend ce qu’il mesure, et rien n’indique que Muse fasse partie des agents testés.
Le catalogue produit devient une vitrine à part entière. Quand Muse passe par une intégration directe — Shopify, les enseignes partenaires — il ne lit peut-être même pas votre page, mais vos données produit : titre, prix, stock, variantes, caractéristiques. Côté Shopify, l’aide indique que la fonction de vente sur les canaux IA, qui inclut Meta, « is active by default for eligible stores » (est active par défaut pour les boutiques éligibles). Un flux produit (le fichier qui décrit tout votre catalogue) incomplet, c’est une fiche que l’agent ne peut pas comparer.
Le trafic d’agent devient invisible dans vos statistiques. Si Muse navigue comme un internaute, une visite de Muse ressemble à une visite humaine dans Google Analytics ou Matomo, vos outils de mesure d’audience. Un taux de conversion (la part des visites qui finissent en achat) qui monte ou une session qui dure trois secondes avant l’achat pourront être le fait d’un agent, sans que rien ne permette de le distinguer à coup sûr.
Ce qui ne change pas : un agent qui cherche un produit sur le web doit d’abord trouver des pages. Tant que Meta ne dit pas comment Muse cherche, rien n’autorise à penser que les fondamentaux du référencement — pages indexables (que les moteurs peuvent ranger dans leur base), contenu clair, réputation de la marque — deviennent inutiles.
Que faire dès maintenant, depuis la France
Muse n’est pas disponible en France, et Meta n’a annoncé aucune date. Ce délai est une chance : il laisse le temps de préparer ce qui sert de toute façon, avec ou sans Muse.
- Passer vos pages clés au crible de l’accessibilité. Fiches produit, tunnel de commande (les étapes jusqu’au paiement), formulaire de contact : chaque bouton a-t-il un libellé écrit, chaque champ une étiquette qui dit ce qu’il attend, chaque image utile un texte alternatif (la description cachée qu’annoncent les lecteurs d’écran) ? L’outil Lighthouse, intégré à Chrome, donne un premier diagnostic en une minute ; il ne repère automatiquement qu’une partie des défauts.
- Vérifier que vos informations clés sont dans le texte, pas dans une image. Un prix, une composition, un délai de livraison incrusté dans un visuel échappe à l’arbre d’accessibilité, sauf s’il est repris dans le texte alternatif.
- Soigner le flux produit. Si vous êtes sur Shopify, ouvrez Sales channels puis Agentic (canaux de vente, puis agentique) : c’est là que se règle la présence de vos produits sur Meta, ChatGPT, Copilot ou Gemini. D’après un relevé du site No Hacks, le canal Meta ne concerne pour l’instant que les boutiques qui vendent aux États-Unis, au Canada et au Mexique : pour un marchand français, c’est un réglage à surveiller, pas encore à activer.
- Décider en connaissance de cause pour les robots de Meta. Bloquer Meta-ExternalAgent (entraînement des modèles) et bloquer Meta-WebIndexer (recherche de Meta AI) ne produisent pas le même effet. Meta écrit que « Allowing Meta-WebIndexer in your robots.txt file helps us cite and link to your content in Meta AI’s responses » (autoriser Meta-WebIndexer dans votre robots.txt nous aide à citer votre contenu et à le lier dans les réponses de Meta AI). Le bloquer risque donc de vous retirer des réponses de Meta AI, et rien n’indique que cela arrêterait Muse.
- Préparer la mesure. Noter dès aujourd’hui vos taux de conversion et durées de session de référence : c’est ce qui permettra, le jour où l’agent arrive, de repérer un changement de comportement.
Ce qui est documenté, observé, inconnu
État au 28 septembre 2026.
| Affirmation | Statut | Source |
|---|---|---|
| Muse est lancé le 8 septembre 2026 aux États-Unis | Documenté | Meta, annonce du 08/09/2026 |
| Muse est disponible aux États-Unis et au Canada | Documenté | TechCrunch, 25/09/2026 |
| Plus de 3,4 millions de téléchargements au 25 septembre | Observé, non documenté par l’éditeur | Sensor Tower via TechCrunch |
| Muse navigue avec un navigateur Chromium dans une machine virtuelle | Documenté | Meta, billet sécurité |
| Muse lit l’arbre d’accessibilité, pas le DOM | Documenté | Meta, billet sécurité |
| La navigation de Muse apparaît comme l’activité de l’utilisateur | Documenté | Meta, billet sécurité |
| Muse n’a pas de user-agent propre que le robots.txt pourrait bloquer | Déduit | Doc des robots de Meta, où Muse n’apparaît pas |
| Une page peu accessible est plus difficile à utiliser pour Muse | Déduit | Arbre d’accessibilité documenté par Meta |
| Amazon bloque Muse par ses conditions d’utilisation | Documenté | Message d’Amazon, via GeekWire |
| Muse accède au catalogue de produits Shopify | Annoncé | TechCrunch, 23/09/2026 |
| Muse pourra se connecter aux applications de Best Buy, Gap, Sephora, Walmart, Wayfair | Annoncé | TechCrunch, 23/09/2026 |
| Sur un site peu accessible, des agents IA accomplissent moins de tâches (31 % contre 96 %) | Observé, non documenté par l’éditeur | AudioEye, 24/09/2026, sans Muse identifié |
| Sur 63 robots.txt lisibles de grands distributeurs américains, 2 bloquent un agent utilisateur ; 42 sites sur 92 refusent leur page d’accueil à un agent | Observé, non documenté par l’éditeur | Major Matters, 25/09/2026 |
| La vente sur les canaux IA de Shopify, Meta compris, est active par défaut pour les boutiques éligibles | Documenté | Aide Shopify |
| Comment Muse cherche une page ou classe deux produits | Non documenté | — |
| Si Muse utilise l’index de Meta-WebIndexer | Non documenté | — |
| Date d’arrivée en France | Non documenté | — |
Documenté : le fonctionnement du navigateur de Muse, sa lecture par l’arbre d’accessibilité et le fait qu’il passe pour l’utilisateur viennent du billet technique de Meta ; le blocage d’Amazon, de son propre message. Annoncé : l’accès au catalogue Shopify et aux applications d’enseignes vient des annonces de Meta Connect. Observé : les téléchargements sont une estimation d’un cabinet tiers, le relevé des distributeurs est le travail d’un seul auteur sur un seul jour, et l’étude sur l’accessibilité vient d’un éditeur du secteur. Inconnu : Meta ne publie ni la façon dont Muse cherche sur le web, ni ses critères de choix entre deux produits. Les trois conséquences pour le SEO et le GEO sont des déductions, qu’aucune mesure ne confirme encore.
Questions fréquentes
Muse est-il disponible en France ?
Non. Au 28 septembre 2026, Muse n’est accessible qu’aux États-Unis et au Canada, et Meta n’a communiqué aucune date pour l’Europe.
Faut-il bloquer Muse dans le robots.txt ?
Rien ne permet de le faire de façon fiable : Muse n’apparaît pas dans la liste des robots documentés par Meta, et il navigue comme l’utilisateur. Amazon a dû passer par ses conditions d’utilisation. Pour un site de taille ordinaire, la question utile est plutôt de savoir si l’on veut qu’un agent puisse acheter chez soi.
Muse va-t-il remplacer Google ?
Rien ne permet de l’affirmer. Muse compte quelques millions de téléchargements en trois semaines, sur deux pays. Ce qui change, c’est le type de visite : un agent qui agit à la place de l’internaute, là où un moteur lui envoyait un visiteur.
Quel lien entre accessibilité et référencement ?
Meta écrit que Muse lit l’arbre d’accessibilité de la page, c’est-à-dire la même structure que les lecteurs d’écran. Une page bien étiquetée pour les personnes malvoyantes est donc, en toute logique, une page plus facile à utiliser pour cet agent.
Pour aller plus loin
Sur ce blog : ce qu’est le GEO, comment un agent de deep research lit vos pages, WebMCP, la déclaration des actions d’un site aux IA et comment bloquer les robots IA.
Sources
- Meta, Introducing Muse, 08/09/2026 — about.fb.com
- Meta, Security and safety for AI agents: our approach with Muse, 08/09/2026 — research.meta.ai
- TechCrunch, Meta is putting its muscle behind Muse as the AI app takes off, 25/09/2026 — techcrunch.com
- TechCrunch, Everything new coming to Meta’s AI agent Muse, 23/09/2026 — techcrunch.com
- Meta, Meta Web Crawlers — developers.facebook.com
- GeekWire, Amazon blocks Meta’s Muse AI assistant, 21/09/2026 — geekwire.com
- Charlie Major, Amazon Blocked Meta’s Shopping Agent in Public. A Third of Big Retailers Do It Quietly., Major Matters, 25/09/2026 — majormatters.co
- Shopify, Agentic storefronts — help.shopify.com
- Google Search Central, User-triggered fetchers — developers.google.com
- Meta, Comment votre agent Muse navigue sur le Web, pages d’aide — meta.com
- AudioEye, étude sur les agents IA et l’accessibilité, 24/09/2026 — prnewswire.com
- No Hacks, Shopify Now Enrols Your Store In Every New AI Shopping Channel — nohacks.co