
Vous avez vu passer Jev à la mi-septembre, puis Clef, Strands Decider et une « Decisions API » (interface de programmation de décisions) chez OpenAI, le tout en trois semaines. Tous promettent la même chose : une IA qui ne rédige rien, qui choisit, et qui le fait dix à cent fois plus vite qu’un ChatGPT. Difficile de savoir ce qui se cache derrière, et si le chiffre de confiance qu’ils affichent veut dire quelque chose. Cet article s’appuie sur ce que publient TypeSafe, Amazon, Cloudflare, OpenAI et Google pour expliquer le mécanisme, comparer les modèles disponibles et repérer les tâches où ils se trompent.
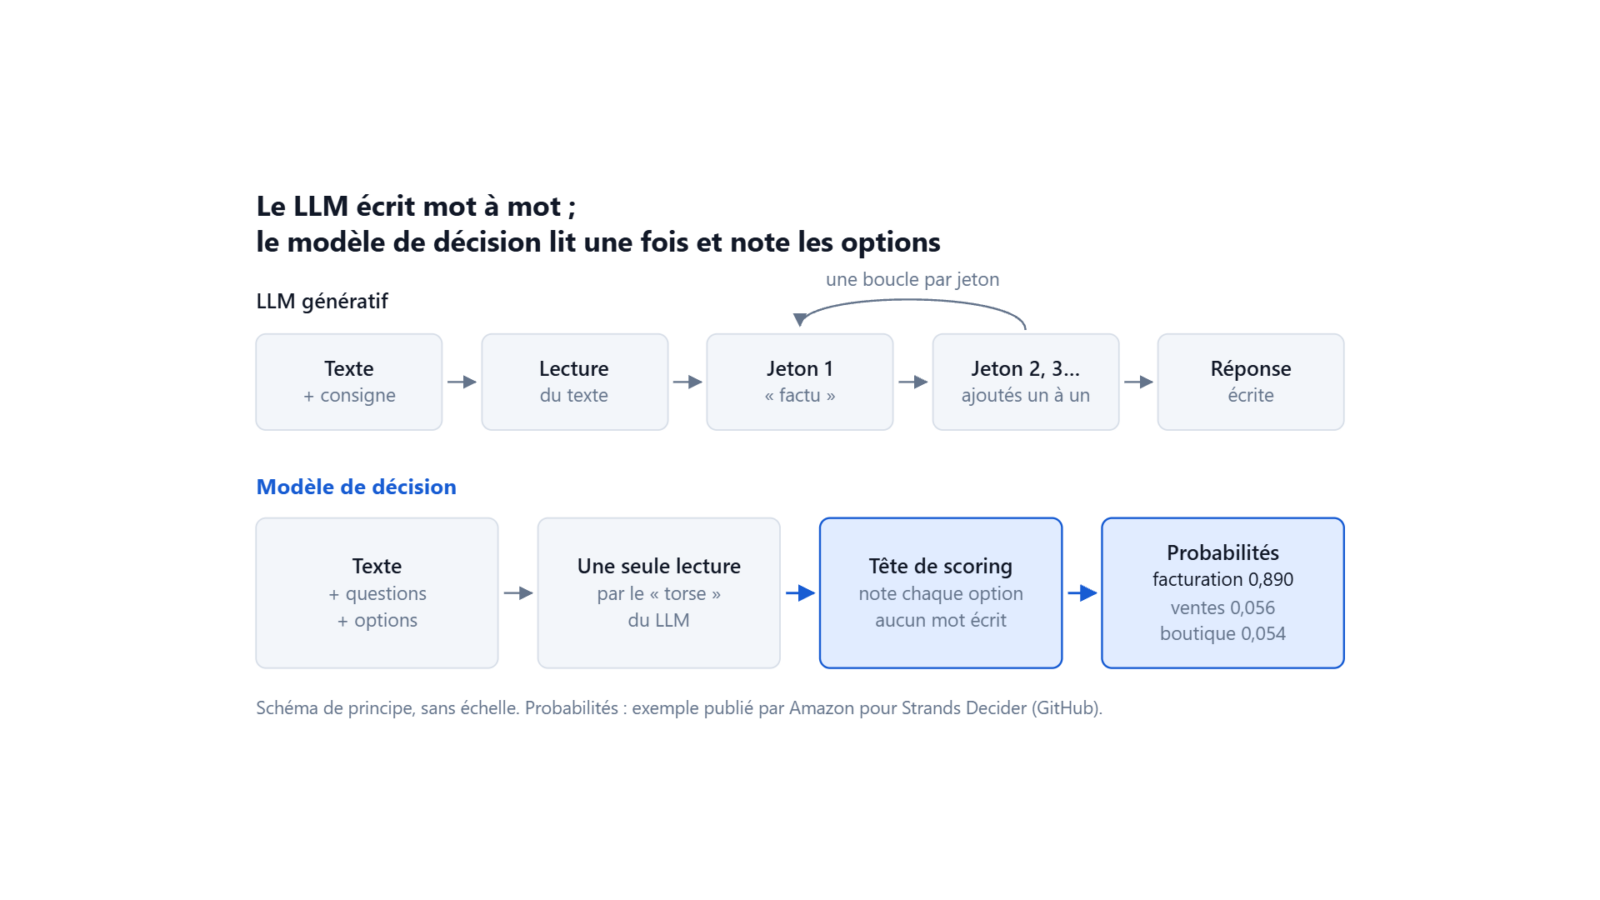
- Un modèle de décision lit votre texte une seule fois et note des réponses que vous lui fournissez. Il n’écrit aucun mot, d’où sa vitesse.
- Les modèles ouverts publient leur recette : un LLM existant privé de sa capacité d’écrire, plus une petite « tête » qui note les options. TypeSafe ne publie pas celle de Jev.
- La probabilité rendue n’a de valeur que si le modèle est calibré, et elle se vérifie sur vos propres exemples.
- Ces modèles sont à l’aise pour trier et aiguiller, et leurs résultats deviennent très inégaux dès que la question demande du jugement.
Ce qu’un modèle de décision fait, et ce qu’il refuse de faire
Un modèle de décision reçoit deux choses. D’abord un « état » : un message client, une fiche produit, une page web, un journal d’application. Ensuite une ou plusieurs questions fermées, chacune avec ses réponses possibles. Il rend, pour chaque question, la réponse retenue et une probabilité pour chaque option.
Trois formes de question reviennent chez tous les éditeurs :
- le choix : une option parmi une liste (« quelle équipe doit traiter ce ticket : facturation, ventes ou technique ? ») ;
- le oui/non : la probabilité qu’une condition soit vraie (« ce message est-il urgent ? »). Amazon et Cloudflare l’appellent
noul, comme l’interface de Jev, OpenAIpredicate; - la note sur une échelle : une position sur des niveaux ordonnés (« impact nul, mineur, majeur, critique »).
Exemple tiré de la documentation d’Amazon, avec sa version de référence (v21) : pour le message « Help! My payouts have been failing for 3 days! » (« Au secours ! Mes virements échouent depuis 3 jours ! »), Strands Decider répond « facturation » avec une probabilité de 0,890, contre 0,056 pour « ventes » et 0,054 pour « boutique ».
La différence avec un ChatGPT à qui l’on demande de répondre par une étiquette tient en une phrase : le LLM peut écrire n’importe quoi, le modèle de décision ne peut rien écrire. Un LLM (grand modèle de langage, comme ceux derrière ChatGPT ou Gemini) qu’on prie de répondre « facturation » peut répondre « Facturation. », « service comptable » ou un paragraphe d’excuses. Un modèle de décision ne sort que l’une des options fournies. TypeSafe, l’éditeur de Jev, le dit ainsi à propos des erreurs de format : « it is mathematically impossible » (« c’est mathématiquement impossible »).
Second écart : le modèle ne rend pas seulement une étiquette, mais une probabilité pour chaque option. Votre code peut donc décider quoi faire quand aucune option ne se détache.
Ce que Jev annonce, et ce que coûte un tri de 40 000 pages avec lui, est détaillé dans l’article consacré à Jev.
Sous le capot : une lecture, puis une tête qui note au lieu d’écrire
La vitesse s’explique par la façon dont un LLM écrit, décrite dans l’article sur la façon dont ChatGPT génère une réponse. Le codelab de Google, un tutoriel pas à pas, la résume ainsi. Le modèle attribue à chaque jeton (morceau de mot) de son vocabulaire un score brut, appelé logit ; une fonction appelée softmax transforme ces scores en probabilités qui totalisent 1 ; puis « A language model then picks one token, adds it to the text, and repeats. A discriminative model stops after the probabilities. » (« Un modèle de langage choisit alors un jeton, l’ajoute au texte, et recommence. Un modèle discriminatif s’arrête après les probabilités. »)
Tout est là. Un LLM paie une boucle par mot écrit. Un modèle de décision lit le texte une fois et s’arrête. Avec deux nuances : le serveur du codelab relit le texte et fait la moyenne quand la première lecture semble incertaine, et TypeSafe procède en deux temps quand une question compte des centaines d’options.
Amazon publie la recette complète de Strands Decider, sous licence libre Apache 2.0 sur la plateforme de code GitHub. Elle part d’un LLM existant, Qwen3.5-2B, de la famille de modèles ouverts Qwen d’Alibaba, dont l’équipe garde le « torse » (torso), c’est-à-dire toutes les couches qui lisent et comprennent le texte. Elle jette la dernière couche, celle qui choisit le mot suivant, et la remplace par une petite « tête » d’environ un million de paramètres (les réglages internes qu’un modèle apprend). La documentation le décrit en une ligne : « One forward pass, no generation, no decoding loop. » (« Une seule passe, aucune génération, aucune boucle de décodage. ») Le torse est ajusté avec un adaptateur LoRA, une technique qui modifie un modèle en n’entraînant qu’une petite fraction de ses poids.
Cloudflare fait de même pour Clef, à plus grande échelle : un Qwen de 27 milliards de paramètres (9 milliards pour Clef-flash), gelé, lit une fois, puis une tête note toutes les options en parallèle.
Conséquence pratique : dix questions sur le même texte ne coûtent guère plus qu’une seule : « the text is read once and each question adds only its own tokens » (« le texte est lu une fois et chaque question n’ajoute que ses propres jetons »), écrit Amazon.
La documentation d’Unsloth, un outil d’entraînement de modèles, montre que la tête fait l’essentiel du travail. Sur son jeu de test, un Qwen3.5 de 0,8 milliard de paramètres utilisé tel quel répond juste à 36 % des questions ; muni d’une tête de type Clef et entraîné une fois sur le jeu de données, il monte à 73 %. Unsloth qualifie le point de départ de « roughly chance level » (« à peu près le niveau du hasard ») et indique 4 Go de mémoire graphique et 42 minutes d’entraînement pour ce modèle.
Reste Jev, le modèle qui a lancé la mode. TypeSafe ne publie pas son architecture : son billet de lancement parle d’une « new model architecture » (« nouvelle architecture de modèle ») et d’un échantillonnage parallèle, sans plus de détail.
Pourquoi ses probabilités ne valent rien sans calibration
Un modèle est dit calibré quand ses probabilités tiennent leurs promesses : parmi toutes les réponses données à 0,9, environ neuf sur dix doivent être justes. C’est la propriété que vendent tous ces éditeurs, et c’est elle qui permet d’automatiser. TypeSafe pose le problème en une phrase : « If a model can do a task 95% of the time but doesn’t say when it’s in the 5%, it can’t automate that task. » (« Si un modèle réussit une tâche 95 % du temps mais ne dit pas quand il est dans les 5 %, il ne peut pas automatiser cette tâche. »)
Un LLM à qui l’on demande sa confiance a tendance à se surestimer, selon le même billet. Les modèles de décision traitent la calibration comme une étape d’entraînement à part :
- Unsloth calibre le modèle sur des exemples mis de côté pendant l’entraînement, « so the model’s probabilities match how often it’s right » (« pour que les probabilités du modèle correspondent à la fréquence à laquelle il a raison ») ;
- Cloudflare ajoute, pendant l’entraînement de Clef, une mesure d’erreur sur les probabilités elles-mêmes, appelée score de Brier, « to refine probability calibration » (« pour affiner la calibration des probabilités ») ;
- TypeSafe et Cloudflare nomment tous deux leur méthode d’entraînement RLCD, pour « apprentissage par renforcement pour des décisions calibrées ».
Amazon est le seul à publier ce que vaut une confiance élevée sur ses propres tests. Sur de courtes tâches de classement que Strands Decider n’a jamais vues, les réponses données avec une confiance de 0,9 ou plus sont justes environ 95 % du temps ; en dessous, la documentation conseille de faire confirmer ou de demander à une personne. L’erreur de calibration moyenne de sa version de référence (l’écart entre confiance affichée et taux de réussite réel) est de 0,064 sur JevBench, un banc d’essai indépendant consacré à ces modèles.
Ces chiffres valent pour les tâches de l’éditeur, pas pour les vôtres. OpenAI le dit dans sa documentation : « Use labeled examples from your application to set thresholds » (« Utilisez des exemples annotés de votre application pour fixer les seuils »), en choisissant le seuil selon ce que coûte une fausse alerte et ce que coûte un cas raté. En pratique : soumettre au modèle quelques centaines de cas dont la bonne réponse est connue, regarder à partir de quelle confiance il ne se trompe presque plus, et n’automatiser qu’au-dessus de ce seuil. Avec une centaine de cas seulement, l’incertitude reste trop grande pour distinguer un seuil fiable à 95 % d’un seuil à 90 %.
Amazon, Cloudflare, OpenAI, Google : qui a sorti quoi en trois semaines
TechCrunch résume la période : « dozens of similar models have been produced by researchers » (« des dizaines de modèles similaires ont été produits par des chercheurs ») depuis l’annonce de TypeSafe. Le tableau ne retient que les grands éditeurs, plus Jev comme référence. Prix et caractéristiques relevés le 9 octobre 2026 sur les pages des éditeurs.
| Modèle | Éditeur | Sortie | Poids du modèle | Entrées | Prix par million de jetons lus | Vitesse annoncée |
|---|---|---|---|---|---|---|
| Jev | TypeSafe | 15 sept. 2026 | fermés | texte | 0,042 $ (sortie gratuite) | 70 à 500 ms (éditeur) |
| Strands Decider 2B | AWS (Strands Labs) | début oct. 2026 | ouverts, Apache 2.0 | texte, images en option | gratuit, sur votre machine | 115 ms médians sur une carte graphique RTX 3090 (éditeur) |
| Clef | Cloudflare | 1er oct. 2026 | ouverts, Apache 2.0 | texte, images | 0,24 $ | 209 ms médians (éditeur) |
| Clef-flash | Cloudflare | 1er oct. 2026 | ouverts, Apache 2.0 | texte, images | 0,09 $ | 38,8 ms médians (éditeur) |
| Decisions API (gpt-6-luna) | OpenAI | bêta publique | fermés | texte, images | 0,10 $ (sortie gratuite) | « environ 10 fois plus rapide » que son API classique (éditeur) |
| — | aucun modèle à son nom au 9 oct. | — | — | — | — |
Le moins cher en service hébergé reste Jev, à 0,042 dollar par million de jetons lus. OpenAI facture plus du double, Clef près de six fois plus. Strands Decider ne coûte rien à l’usage, mais il faut le faire tourner soi-même.
Les modèles ouverts, dont les poids sont téléchargeables, sont les seuls dont on connaît la recette. OpenAI ne décrit pas comment fonctionne sa Decisions API, son interface de programmation dédiée : sa documentation présente gpt-6-luna comme le seul modèle disponible, sans dire s’il s’agit d’un LLM contraint ou d’un modèle dédié.
Les vitesses ne se comparent pas d’une ligne à l’autre. Chaque éditeur mesure sur son propre matériel. Cloudflare a mesuré Jev avec ses propres modèles sur 43 bancs d’essai (des séries de tests standardisés) : en valeur médiane, la moitié des réponses arrivant plus vite, 524 ms pour Jev, 209 ms pour Clef, 38,8 ms pour Clef-flash. C’est la seule mesure publiée qui place Jev face à ses concurrents, et elle vient de l’un d’eux.
Google n’a pas, au 9 octobre, de modèle de décision à son nom. Il publie en revanche un codelab qui appelle Jev, ou fait tourner DiffusionGemma, un modèle ouvert de Google DeepMind, derrière une interface compatible. Le même tutoriel montre l’astuce qui suffit à transformer un modèle génératif en modèle de décision : « The server keeps only the logits of the allowed labels and applies a softmax to them » (« Le serveur ne garde que les logits des étiquettes autorisées et leur applique une softmax »).
Là où ces modèles se trompent, et ce qui fait mieux
Les chiffres publiés par Cloudflare sont les plus parlants, parce qu’ils montrent aussi les faiblesses de son propre modèle. Sur le classement d’intentions bancaires (BANKING77, 77 catégories de demandes clients), Clef obtient 94,2 contre 79,7 pour Jev. Sur When2Call, un test qui vérifie si un agent IA (un programme qui enchaîne des actions seul) sait quand appeler un outil, quand demander une précision et quand s’abstenir, c’est l’inverse : 81,0 pour Jev, 72,4 pour Clef. Les deux tests n’emploient pas la même mesure de réussite, et l’écart ne dit pas qu’un modèle de décision échoue au jugement : Jev y obtient le meilleur score du tableau. Il dit que, sur ce type de question, les résultats varient fortement d’un modèle à l’autre.
Amazon affiche un profil comparable. Sur le jeu public de JevBench, un banc d’essai indépendant consacré à ces modèles, découpé en trois niveaux par Amazon, la version de référence de Strands Decider répond juste à toutes les tâches faciles, 93 % des tâches standard, et 55 % des tâches difficiles.
Le relevé le plus utile vient d’un utilisateur, l’auteur de l’outil Empryo, qui a essayé Jev sur huit tâches de son propre logiciel et en a écarté trois après mesure (billet du 16 septembre 2026). Confier à Jev le classement de lignes isolées trouvées par une recherche dans le code a fait baisser la précision : « dropped top-3 accuracy from 78.6% to 74.1% » (« a fait chuter l’exactitude dans les trois premiers résultats de 78,6 % à 74,1 % »). L’explication tient en une phrase : « One line of code carries too little meaning on its own. » (« Une ligne de code porte trop peu de sens à elle seule. ») Sa conclusion vaut au-delà de Jev : « When an index, a graph or a simple rule already captures the answer, plain code is faster, cheaper and more reliable. » (« Quand un index, un graphe ou une règle simple capture déjà la réponse, du code ordinaire est plus rapide, moins cher et plus fiable. »)
Le fondateur de TypeSafe, Diogo Almeida, prévient lui-même ses imitateurs, dans TechCrunch : ils pourraient « be underestimating the difficulty of making the models actually smart » (« sous-estimer la difficulté de rendre les modèles réellement intelligents »).
Un modèle de décision est donc à sa place quand quatre conditions sont réunies : la question est fermée, les réponses possibles sont connues d’avance, le texte à juger porte assez de sens, et le volume est assez grand pour que la vitesse compte. Quand la réponse demande de raisonner en plusieurs étapes, un LLM reste meilleur ; quand une règle simple suffit, du code suffit.
Ce que ça change pour un site
Cette section mélange deux choses qu’il faut séparer : ce que les éditeurs montrent, et ce qu’on peut en déduire.
Ce qui est montré. Cloudflare utilise déjà Clef pour classer des sites web. Son équipe de veille sur les menaces lui confie un nom de domaine, associé à un navigateur automatisé qui récupère et affiche la page. Clef rend par exemple « 95 % de chances que ce soit un site de mode, 85 % de commerce en ligne, moins de 1 % d’hameçonnage ». Le circuit complet prend 2,2 secondes, contre 4,7 secondes avec le LLM généraliste le plus rapide de Cloudflare, qui ne rendait que deux catégories. OpenAI cite, parmi les usages de ses questions oui/non, la vérification de la pertinence d’un passage de texte. Et Amazon liste l’aiguillage des demandes, le choix d’outil et les garde-fous de sécurité parmi les usages naturels dans les agents IA.
Ce qu’on peut en déduire, sans qu’aucun moteur l’ait confirmé. Un agent IA qui parcourt le web pour le compte d’un utilisateur, comme ceux décrits dans l’article sur le deep research, prend des dizaines de petites décisions fermées : ouvrir ce lien ou non, ce passage répond-il à la question, cette page est-elle une boutique. Ces décisions deviennent assez bon marché pour être prises sur chaque page visitée. Une page dont la nature est ambiguë récolte alors des probabilités partagées entre plusieurs catégories, là où une page claire en obtient une seule, nettement.
Côté pratique, pour un référenceur, l’usage immédiat est interne : classer des milliers de pages par type, repérer les pages hors sujet, et, à tester d’abord sur un échantillon, qualifier des mots clés par intention de recherche. Ce sont des questions fermées à gros volume. Mais un mot clé de trois mots porte peu de sens, comme la ligne de code d’Empryo : le seuil de confiance se fixe sur vos propres exemples avant toute automatisation. L’ordre de grandeur des économies est calculé dans l’article sur Jev.
Ce qui est établi, ce qui est déduit, ce qui reste inconnu
Établi : le principe, décrit par Amazon, Cloudflare et Google, et les prix, relevés le 9 octobre 2026. Déclaré : vitesses, scores et calibration, mesurés par les éditeurs eux-mêmes. Déduit : l’usage par les agents qui parcourent le web. Inconnu : l’architecture de Jev et de la Decisions API.
| Affirmation | Statut | Source |
|---|---|---|
| Un modèle de décision ne produit aucun texte, il note des options fournies | Documenté | Amazon (GitHub), Cloudflare (blog), Google (codelab) |
| Strands Decider remplace la dernière couche d’un Qwen3.5-2B par une tête d’environ un million de paramètres | Documenté | Amazon (GitHub) |
| Sans tête entraînée, un petit Qwen répond à peu près au niveau du hasard sur le jeu de test d’Unsloth | Documenté | Unsloth (documentation) |
| Les réponses de Strands Decider données à 0,9 ou plus sont justes environ 95 % du temps | Déclaré | Amazon, sur de courtes tâches de classement |
| Clef bat Jev sur le classement d’intentions (BANKING77) | Déclaré | Cloudflare, concurrent de Jev |
| Jev bat Clef sur la décision d’appeler ou non un outil (When2Call) | Déclaré | Cloudflare, mesure différente de BANKING77 |
| La Decisions API répond environ 10 fois plus vite que l’API classique d’OpenAI | Déclaré | OpenAI (documentation) |
| L’architecture de Jev et celle de la Decisions API sont publiques | Faux | TypeSafe et OpenAI ne la décrivent pas |
| Google commercialise son propre modèle de décision | Faux au 9 oct. 2026 | Codelab Google : Jev ou DiffusionGemma |
| Les agents qui parcourent le web utiliseront ces modèles pour trier les pages | Déduit | Aucun moteur ne l’a confirmé |
Questions fréquentes
Un modèle de décision peut-il se tromper avec aplomb ?
Oui. Le format de la réponse est garanti, pas sa justesse. Même chez Strands Decider, les réponses données avec une confiance de 0,9 ou plus restent fausses environ une fois sur vingt, d’après Amazon. D’où l’intérêt de fixer un seuil sur vos propres exemples, et de faire relire ce qui tombe en dessous.
Peut-on en faire tourner un sur son ordinateur ?
Oui, avec les modèles ouverts, c’est-à-dire ceux dont les poids (les paramètres appris) sont téléchargeables. Amazon indique 153 ms médians par question pour Strands Decider sur un ordinateur Apple à puce M3 Pro, pour des textes de moins de 300 jetons. Unsloth montre qu’on peut entraîner son propre modèle de décision à partir d’un Qwen de 0,8 milliard de paramètres avec 4 Go de mémoire graphique.
Quelle différence avec un classifieur classique ?
Un classifieur classique apprend une liste d’étiquettes fixée à l’entraînement : changer de catégories impose de le réentraîner. Un modèle de décision reçoit les options dans chaque requête. Chez Strands Decider, les listes d’étiquettes « sont définies par la requête plutôt qu’inscrites dans les poids », selon Amazon.
Google a-t-il son propre modèle de décision ?
Pas au 9 octobre 2026. Google publie un tutoriel qui appelle Jev ou fait tourner son modèle ouvert DiffusionGemma, dans un circuit d’agent qui utilise aussi Gemini.
Sources
- TypeSafe, « Introducing System One Models & Jev », 15 septembre 2026 — typesafe.ai
- Amazon, Strands Labs, dépôt « strands-decider », consulté le 9 octobre 2026 — github.com
- Cloudflare, « Introducing Clef: our open-source decision models », 1er octobre 2026 — blog.cloudflare.com
- Cloudflare, fiches des modèles Clef et Clef-flash, consultées le 9 octobre 2026 — developers.cloudflare.com
- OpenAI, guide « Decisions », consulté le 9 octobre 2026 — developers.openai.com
- Google, codelab « Getting started with Discriminative (Jev/DiffusionGemma) models », consulté le 9 octobre 2026 — codelabs.developers.google.com
- Unsloth, « Train your own Decision Model with Unsloth », consulté le 9 octobre 2026 — unsloth.ai
- Empryo, « Jev and the harness », 16 septembre 2026 — empryo.com
- TechCrunch, Tim Fernholz, « Amazon releases its own Jev clone as decision models flood the web », 1er octobre 2026 — techcrunch.com