
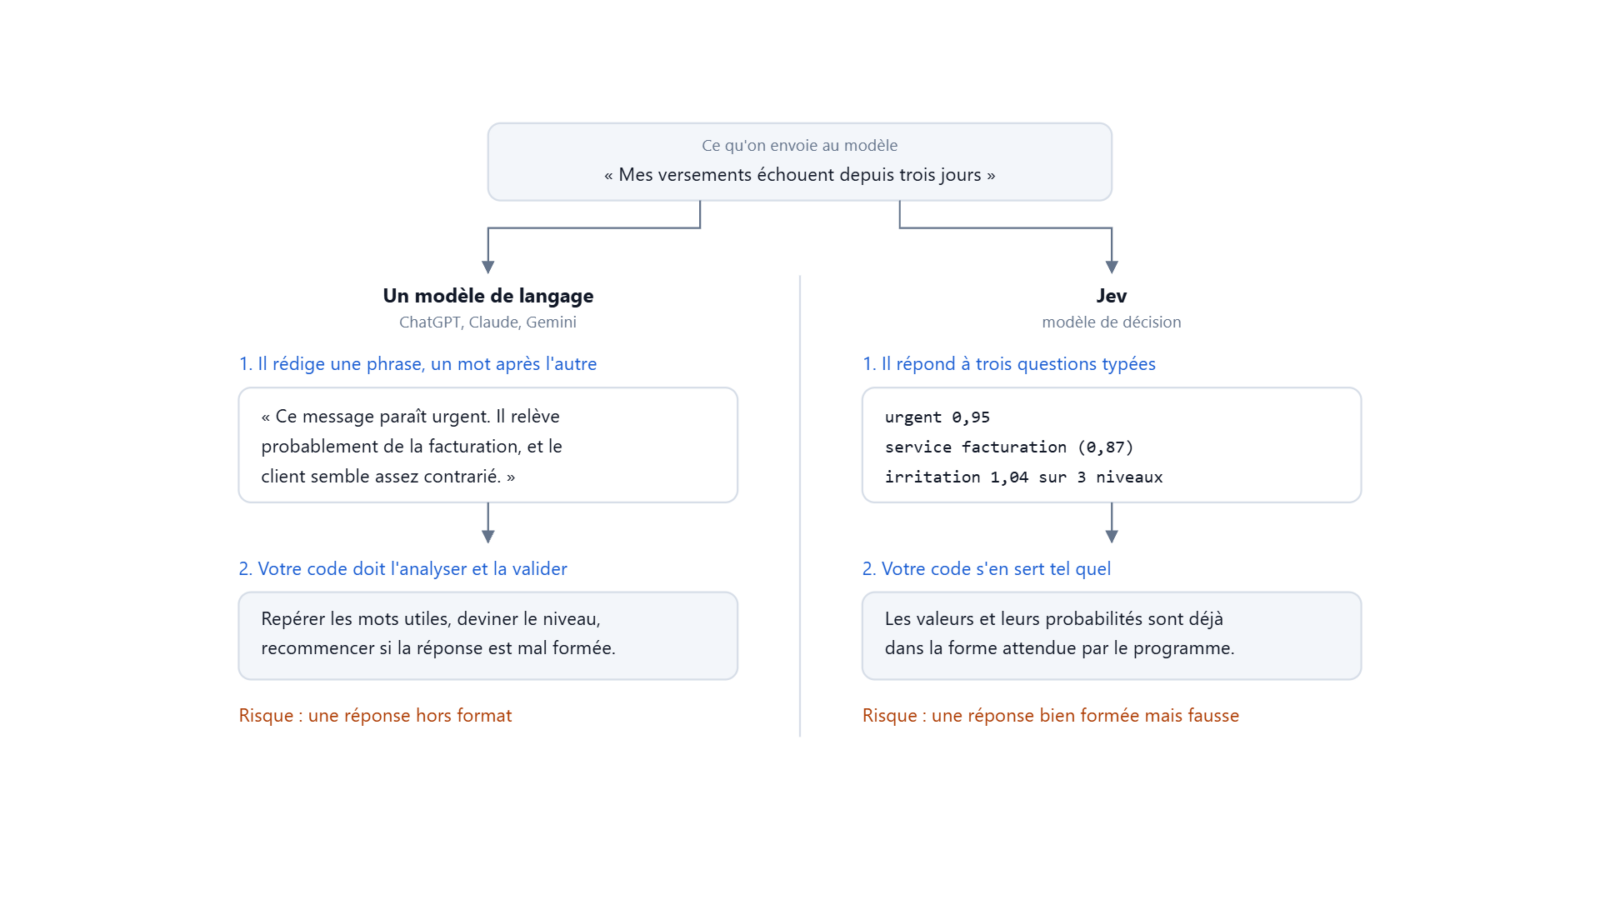
Vous avez 40 000 adresses à trier par intention de recherche, ou 3 000 textes à noter avant publication. Vous ouvrez un assistant d’IA, vous écrivez la consigne, et il répond par une phrase — qu’il faut ensuite relire, découper, ranger dans un tableur. Multiplié par 40 000, ce détour coûte des heures et une facture. Le 15 septembre 2026, une jeune société américaine a publié un modèle bâti pour l’éviter : il ne rédige rien, il renvoie directement la valeur. Voici ce qu’il fait, ce que ça coûte, et ce qui est mesuré à ce jour.
Ce que TypeSafe a annoncé le 15 septembre
TypeSafe AI est fondée par Diogo Almeida, ancien chercheur d’OpenAI, que l’entreprise présente comme co-inventeur de la méthode d’entraînement qui a donné ChatGPT. Le 15 septembre, elle a publié Jev — version jev-1.13 —, présenté comme le premier d’une famille qu’elle appelle System One Models :
« a new class of frontier models built to make fast, structured decisions that software can use directly »
— « une nouvelle classe de modèles de pointe conçus pour prendre des décisions rapides et structurées que le logiciel peut utiliser directement ».
La différence avec ChatGPT ou Claude tient en une phrase : ces derniers produisent du texte, Jev produit une valeur. Il accepte trois formes de questions, et rien d’autre. Choice choisit une option dans une liste, 255 au maximum. Score note sur une échelle dont vous définissez les niveaux. Noul renvoie la probabilité qu’une affirmation soit vraie. Choice et Score s’accompagnent de deux nombres qui font tout l’intérêt du modèle : la probabilité attribuée à chaque réponse possible, et un indice de confiance, qui dit à quel point le modèle hésite entre elles. Noul, lui, ne renvoie que sa probabilité.
Sur la phrase « mes versements échouent depuis trois jours », l’exemple publié par Cloudflare renvoie : urgence 0,95 ; service compétent « facturation », probabilité 0,87, confiance 0,80 ; irritation notée 1,04 sur trois niveaux. Aucune phrase à décortiquer : la réponse est déjà un objet que le code consomme.
Les chiffres annoncés par l’éditeur sont spectaculaires. Le temps de réponse va de 70 à 500 millisecondes, contre 3 à 329 secondes pour les modèles de pointe ; à intelligence comparable, l’éditeur en tire un gain « de 40 à 200 fois ». Les jetons d’entrée — les tokens, ces fragments de texte qu’un modèle facture à l’unité, l’entrée étant ce qu’on lui envoie et la sortie ce qu’il produit — coûtent 0,042 $ par million, et la sortie est gratuite : « too cheap to meter », trop bon marché pour être comptée. Quant au nom, l’éditeur dit l’avoir emprunté à l’économiste William Stanley Jevons, qui avait observé que le rendement des machines à vapeur avait fait augmenter la consommation de charbon.
Ce que ça change quand on doit trier des milliers de pages
Le SEO est plein de tâches qui sont des questions fermées posées un très grand nombre de fois : classer des adresses par intention de recherche, séparer les requêtes de marque des autres, noter une page sur une grille de qualité, repérer deux pages qui répondent à la même question, vérifier un texte produit par IA avant publication. Dans tous ces cas, on ne veut pas une rédaction : on veut une étiquette et un niveau de certitude.
Ce que ça coûte se calcule, aux tarifs affichés le 18 septembre :
| Hypothèse ou tarif | Facture | |
|---|---|---|
| Le travail | 40 000 pages, 500 jetons chacune (titre, adresse, extrait) = 20 millions de jetons en entrée ; 40 jetons de réponse par page | — |
| Jev | 0,042 $ le million en entrée, sortie gratuite | 0,84 $ |
| GPT-5.6 Terra | 2 $ le million en entrée, 12 $ en sortie | 59,20 $ |
| Rapport | ≈ 70 fois |
Calcul propre à partir des tarifs publiés par les deux éditeurs. Le rapport dépend entièrement des hypothèses de volume ci-dessus : une réponse plus longue le creuse, un texte source plus court le réduit.
Une réserve, et elle est sérieuse : rien de tout cela n’est nouveau en tant que fonction. Un classifieur — un petit modèle entraîné à ranger des textes dans des cases — fait déjà ce travail pour presque rien, et les grands fournisseurs proposent depuis longtemps des sorties contraintes, c’est-à-dire un format de réponse imposé au modèle à l’avance. Ce que Jev ajoute, c’est de le faire sans données d’entraînement, avec des probabilités, et à cette vitesse.
Ce qui est mesuré, et ce qui ne l’est pas
Deux tests publics sont parus dans les jours suivant l’annonce. Le plus chiffré est celui de l’éditeur d’agents Empryo, le 16 septembre, sur 102 pannes réelles de fournisseurs d’API qu’il fallait classer en « à réessayer » ou « définitive » : Jev répond juste 102 fois sur 102, en 273 millisecondes médianes et 0,00002 $ par vérification, contre 1 387 millisecondes et 0,00250 $ pour GPT-5.6 Terra, qui se trompe une fois de retentative. L’auteur intègre Jev dans son propre produit : ce n’est pas un laboratoire neutre.
Et c’est justement la partie négative de son relevé qui est la plus utile. Sur huit tâches essayées, il en a écarté trois après mesure, parce que du code ordinaire faisait mieux : classer des lignes de résultats de recherche textuelle avec Jev fait tomber la précision de 78,6 % à 74,1 %, et sur la validation d’une boucle de correction automatique, le modèle n’a suivi le jugement humain que dans 12 cas ambigus sur 20. Personne n’a en revanche publié de comparaison entre Jev et un classifieur entraîné sur les données du site : sur ce point précis, l’univers de preuve est vide.
Les gains affichés sur la page d’accueil de l’éditeur — 193,6 fois plus rapide, 444,6 fois moins cher — restent, eux, des évaluations maison, dont il décrit lui-même la méthode : la réponse de référence n’est pas une vérité établie mais la moyenne des réponses de deux modèles concurrents, ce qui, précise-t-il, « biaise les réponses vers les modèles d’OpenAI et d’Anthropic » — donc, en principe, à son propre désavantage. C’est une divulgation honnête, mais elle ne remplace pas une mesure indépendante.
L’argument le plus repris mérite le même examen. TypeSafe écrit que Jev « ne peut pas halluciner », c’est-à-dire inventer une information fausse avec aplomb. The Register a objecté le 16 septembre que la comparaison n’est pas loyale, puisque la sortie n’est pas du langage naturel, et que le modèle « retourne des réponses structurées assorties de probabilités, ce qui n’exclut pas la possibilité qu’elles soient fausses ». Un choix limité à 255 options ne peut pas en inventer une 256ᵉ ; il peut parfaitement désigner la mauvaise. L’éditeur publie d’ailleurs sa propre liste de faiblesses, revue le 17 septembre : neuf modes d’échec, dont l’arithmétique, la comparaison de dates, et le contenu hostile — le modèle n’est pas entraîné à traiter ce qu’on lui soumet comme potentiellement malveillant. Pour qui envisagerait de lui faire noter des textes ramassés sur le web, c’est à lire avant le reste.
Reste la disponibilité, et elle a bougé en trois jours. L’accès direct chez l’éditeur passe par une liste d’attente, et sa page de tarifs renvoie une erreur ; mais Cloudflare documente le modèle dans son catalogue avec un exemple d’appel complet, et depuis le 18 septembre la place de marché OpenRouter le propose publiquement, au tarif annoncé, avec une fenêtre de contexte — la quantité de texte qu’on peut lui envoyer en une fois — de 32 000 jetons.
Ce qui est établi, ce qui est déduit, ce qui reste inconnu
Documenté : les trois formes de questions, la limite de 255 options, les tarifs et temps de réponse annoncés, les neuf faiblesses reconnues, la mise à disposition chez Cloudflare et OpenRouter. Mesuré par un tiers : les latences et les coûts par appel du relevé Empryo, et les trois tâches où le code ordinaire l’emporte. Déduit : le rapport de coût d’environ 70, qui découle des tarifs affichés et d’hypothèses de volume explicitées. Inconnu : la performance face à un classifieur entraîné, et la tenue des tarifs dans le temps.
| Affirmation | Statut | Référence |
|---|---|---|
| Jev renvoie des décisions typées, pas du texte | Documenté | Billet TypeSafe, 15/09/2026 |
| Trois formes de questions — Choice, Score, Noul — dont un Choice plafonné à 255 options | Documenté | Documentation TypeSafe, page Choice |
| 70 à 500 ms, 0,042 $ le million de jetons en entrée, sortie gratuite | Documenté | Billet TypeSafe, 15/09/2026 |
| Disponible publiquement chez OpenRouter et au catalogue Cloudflare | Documenté | OpenRouter, 18/09/2026 ; Cloudflare |
| 102 décisions justes sur 102, 273 ms médianes, 0,00002 $ par vérification | Mesuré | Empryo, 16/09/2026, éditeur non neutre |
| Trois tâches sur huit où du code ordinaire fait mieux que Jev | Mesuré | Empryo, 16/09/2026 |
| 193,6 fois plus rapide et 444,6 fois moins cher | Imprécis | Évaluation interne, référence = moyenne de deux modèles concurrents |
| « Ne peut pas halluciner » vaut pour le format, pas pour la justesse | Déduit | Objection de The Register, 16/09/2026 |
| Environ 70 fois moins cher sur un tri de 40 000 pages | Déduit | Calcul à partir des tarifs affichés |
| Une comparaison publique entre Jev et un classifieur entraîné | Non documenté | Aucune trouvée au 18/09/2026 |
Documenté : une phrase copiable de la source. Mesuré : un relevé chiffré publié par un tiers, avec son dispositif. Déduit : conséquence logique de faits documentés, que personne n’écrit ainsi. Imprécis : le chiffre existe, mais sa méthode de mesure ne permet pas d’en tirer ce qu’on voudrait. Non documenté : personne ne le publie.
Questions fréquentes
Peut-on l’utiliser dès aujourd’hui pour un projet SEO ? Oui, par OpenRouter ou par Cloudflare, sans attendre la liste d’attente de l’éditeur. Mais avant de s’y engager, la comparaison honnête n’est pas « Jev contre ChatGPT » : c’est « Jev contre un classifieur entraîné sur vos propres données », moins cher encore sur une tâche fixe, et « Jev contre trois lignes de code », qui gagnent plus souvent qu’on ne le croit — le relevé d’Empryo le montre sur trois tâches sur huit.
Un résultat au bon format est-il un résultat juste ? Non, et c’est le point à retenir. La garantie porte sur la forme de la réponse, pas sur son exactitude. Une étiquette fausse reste une étiquette fausse, même livrée en 80 millisecondes avec une probabilité à deux décimales.
Sources
- typesafe.ai — « Introducing System One Models & Jev », Diogo Almeida, 15/09/2026
- docs.typesafe.ai — page Choice, dont la limite de 255 options
- docs.typesafe.ai — « Jev 1.13 jaggedness », revu le 17/09/2026
- theregister.com — Thomas Claburn, 16/09/2026
- empryo.com — « Software needs decisions, not chat », 16/09/2026
- developers.cloudflare.com — fiche du modèle au catalogue Workers AI
- openrouter.ai — fiche tarifaire publique, mise en ligne le 18/09/2026
Relevé effectué le 18 septembre 2026. Le produit est en accès anticipé : ses tarifs et ses limites peuvent changer sans préavis.
À voir aussi
- Comment ChatGPT génère-t-il une réponse ? — pourquoi un modèle de langage produit du texte mot après mot
- Le GEO, c’est quoi ? Se faire citer par les IA
- Quality raters : comment Google juge la qualité d’une page — la grille de notation qu’on cherche justement à automatiser
- Agent harness : pourquoi le modèle ne suffit pas