
Andrej Karpathy a cofondé OpenAI, dirigé l’IA chez Tesla, et explique publiquement depuis dix ans comment fonctionnent les LLM — les grands modèles de langage, ces programmes qui produisent du texte mot après mot. Il ne parle presque jamais de référencement : c’est la première chose à savoir avant de lire ce qui suit. Ce qui est documenté ici, c’est ce qu’il a écrit ou dit, en quinze phrases datées, de son billet « Software 2.0 » de novembre 2017 à sa conférence chez Sequoia du 20 avril 2026. Ce qui est déduit, c’est la conséquence pour un site. Et ce qui est observé contredit un de ses conseils : sur le fichier qu’il proposait de publier à l’intention des IA, une mesure de mai 2026 dit qu’il n’est presque jamais lu.
Ce que fait vraiment un modèle de langage
1. Il ne lit pas vos mots, il lit des tokens
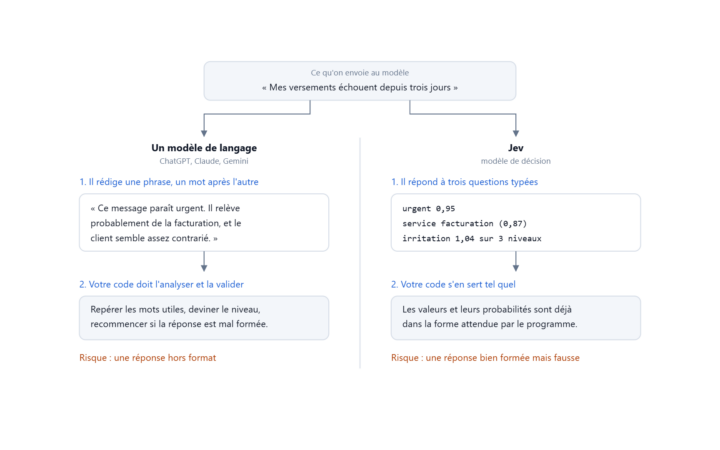
Un token, c’est un morceau de mot : l’unité que le modèle manipule réellement. Dans le dépôt de son cours de février 2024, Karpathy écrit que « la tokenization est au cœur d’une bonne part des bizarreries des LLM ». Il répond ensuite par ce seul mot à une litanie de questions — pourquoi un modèle épelle mal, calcule mal, et pourquoi il est moins bon hors de l’anglais. Pour un site francophone, la conséquence est concrète : à contenu égal, un texte français coûte plus de tokens qu’un texte anglais. Il rentre moins bien. La suite du mécanisme est dans comment un texte devient une liste de nombres.
2. L’hallucination n’est pas une panne, c’est le régime normal
Le 9 décembre 2023 : « en un sens, halluciner est tout ce que font les LLM — ce sont des machines à rêver ». On oriente le rêve par la question posée ; on ne parle d’hallucination que quand il tombe faux. Un moteur peut donc déformer ce que vous avez écrit sans qu’aucun bug ne se produise. La parade n’est pas d’écrire plus, c’est d’écrire des phrases difficiles à mal reformuler : une idée, un chiffre, une phrase.
3. La fenêtre de contexte est un bureau, pas un coffre-fort
La fenêtre de contexte, c’est la quantité de texte que le modèle a sous les yeux pour répondre. En juin 2025, Karpathy la compare à « la mémoire » d’un système d’exploitation ; en avril 2026, il durcit : « ce qu’il y a dans la fenêtre de contexte, c’est votre levier ». Ce qui n’y entre pas n’existe pas pour la réponse. Une page qui met deux mille mots à énoncer son idée se bat pour une place qu’elle occupe mal — mécanisme visible dans l’article deep research.
4. Le modèle ne se souvient pas de vous
Juin 2025 : les modèles « souffrent d’une forme d’amnésie antérograde », l’incapacité à fixer un souvenir nouveau. Chez Dwarkesh Patel, en octobre 2025, il répète qu’on ne peut pas leur dire une chose et compter qu’ils la retiennent. Conséquence : aucune autorité ne se capitalise d’une conversation à l’autre. Votre marque est à réétablir à chaque réponse, et elle ne l’est que par ce que d’autres sources répètent de vous.
5. Leur intelligence est dentelée
Juillet 2024, il forge « jagged intelligence » — intelligence dentelée — pour nommer « le fait, étrange et contre-intuitif, que les meilleurs LLM réussissent des tâches très impressionnantes tout en butant sur des problèmes très bêtes ». Autrement dit : un moteur capable de résumer votre secteur peut se tromper sur vos horaires. Une bonne réponse ne prouve pas que votre site est bien compris.
Pourquoi les contenus produits par IA se ressemblent
6. L’entraînement « aspire la supervision à la paille »
Sur l’apprentissage par renforcement — la phase où le modèle est récompensé selon la qualité jugée de ses réponses —, il est cash en octobre 2025 : « l’apprentissage par renforcement, c’est terrible ». Et il enchaîne aussitôt sur la nuance qui compte : tout ce qu’on avait avant est bien pire, puisqu’on se contentait d’imiter des humains. Le défaut qu’il pointe : « on aspire la supervision à la paille » — une note finale unique est étalée sur toute la trajectoire qui y a mené. La déduction, pour un site : le modèle n’est pas optimisé pour avoir raison, il l’est sur un signal étroit.
7. Ce qu’un modèle écrit est « silencieusement effondré »
Même entretien : « tous les échantillons que vous obtenez des modèles sont silencieusement effondrés » — posez dix fois la même question, vous obtenez dix fois à peu près la même chose, la variété apparente masquant une distribution rétrécie. C’est la raison mécanique pour laquelle les pages écrites à l’IA convergent. Ce qu’un modèle ne peut pas aplatir, c’est une mesure, une date, un chiffre relevé. Le reste, il le produit déjà.
L’agent est un nouveau destinataire, et il faut lui écrire
8. Une nouvelle catégorie de lecteur
Juin 2025, deux idées à garder distinctes. La première : les modèles sont « des esprits de personnes », des « simulations stochastiques de personnes ». La seconde : « il y a une nouvelle catégorie de consommateur et de manipulateur d’information numérique », entre l’humain qui lit une page et le programme qui appelle une interface — c’est là que se rangent les agents, ces programmes qui naviguent et agissent à la place d’un utilisateur. La mesure existe : le 3 juin 2026, Cloudflare relève 57,5 % de requêtes HTTP automatisées vers du contenu HTML, contre 42,5 % venant de personnes. Réserve décisive : ce chiffre couvre tous les robots — moteurs, surveillance, aspirateurs — sans ventilation des agents IA. Comment un site peut leur parler : WebMCP.
9. Sa bête noire : les documentations écrites pour des humains
À Sequoia, le 20 avril 2026, il désigne « des docs fondamentalement écrites pour des humains » comme sa bête noire, et pose la question qui sert de test : « quelle est la chose que je dois copier-coller à mon agent ? » C’est le conseil le plus actionnable de la liste : votre site devrait avoir une page qui y répond — ce qu’il fait, où sont les informations clés, en texte simple. Pas un document de plus : une page qu’on peut coller.
10. Et pourtant, le fichier destiné aux IA n’est presque jamais lu
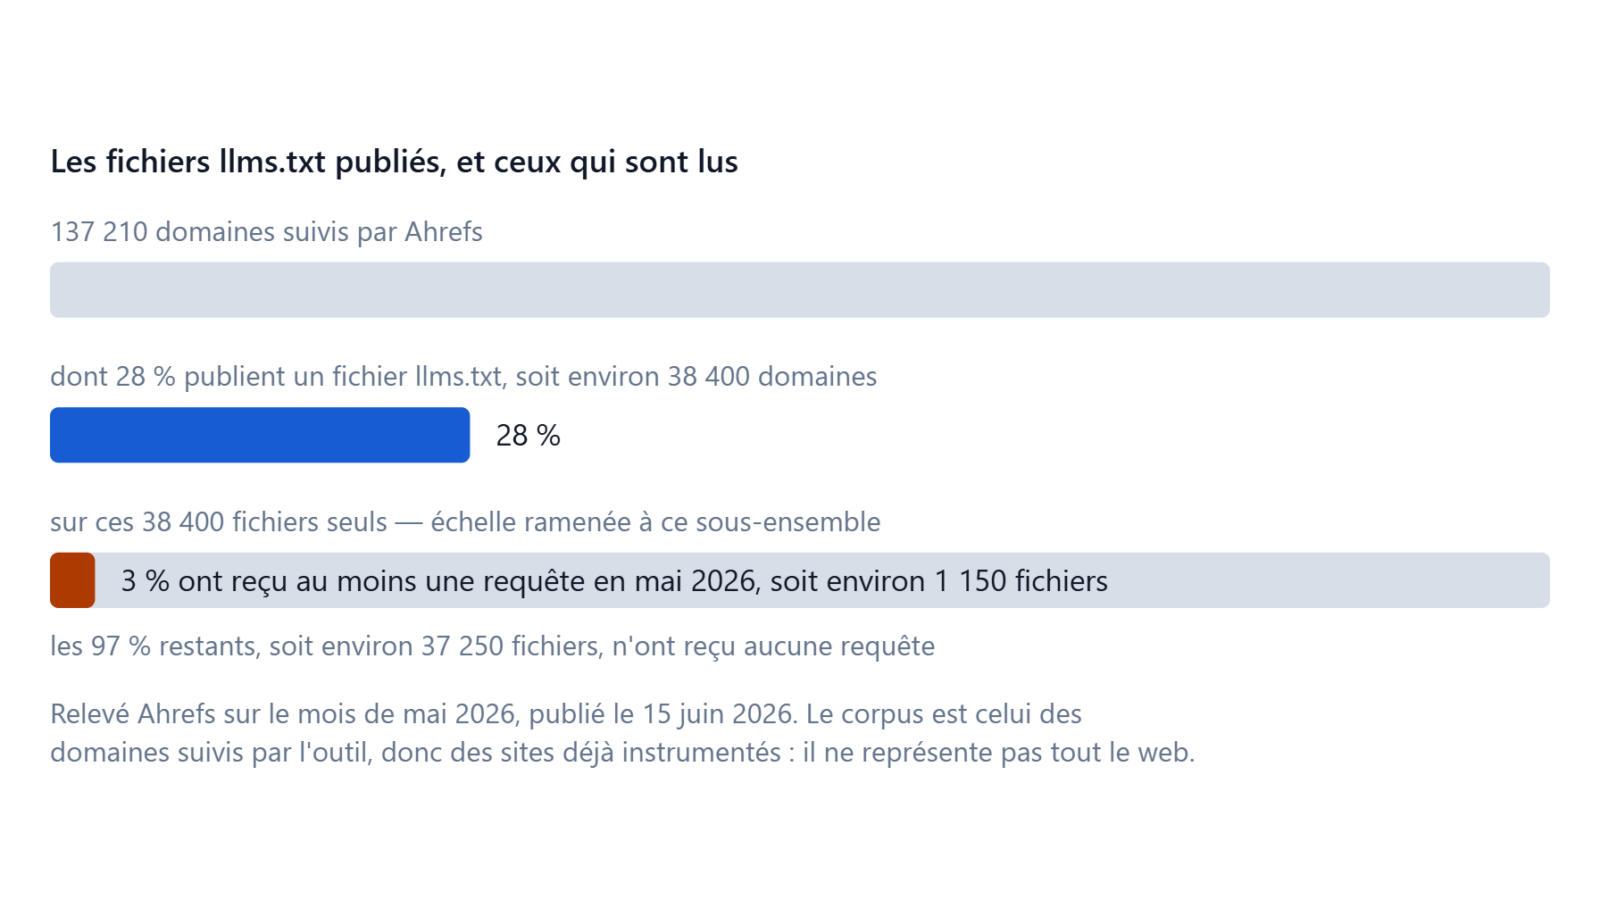
En juin 2025, il suggérait — « on peut peut-être avoir un fichier », pas davantage — un llms.txt : un simple fichier texte qui dit aux modèles de quoi parle le domaine, plutôt que de leur faire analyser du HTML, « sujet à erreur et difficile ». La mesure dit autre chose. Ahrefs a examiné 137 210 domaines qu’il suit, donc déjà instrumentés : 28 % publient ce fichier, et 97 % de ceux-là « n’ont vu aucune requête, absolument aucune » en mai 2026 — environ 1 150 fichiers réellement récupérés sur 38 400. Les outils IA le prennent quand un lien ou une consigne leur dit qu’il existe ; ils ne le cherchent pas. Et Google documente non pas un usage, mais son absence d’usage : créer ces fichiers « ne nuira ni n’aidera à la visibilité de votre site dans Google Search, puisque Google Search les ignore ». Pour un site : écrire lisible, oui ; publier un fichier que personne ne demande, non. Le fichier robots.txt, lui, est bien lu.
11. Le LLM Wiki : l’IA compile vos sources au lieu de les relire
Avril 2026, dans une note publique : « Obsidian est l’atelier, le LLM est le programmeur, le wiki est la base de code ». Les sources brutes ne bougent plus ; le modèle les compile une fois en notes markdown reliées — un format texte léger, facile à analyser — où chaque affirmation dérivée pointe vers sa source. Ce que ça change pour une page : elle n’est pas relue à chaque question, elle est lue une fois et digérée. Ce qui survit à la digestion, c’est ce qui est citable — une phrase datée, un chiffre attribuable.
12. Le prompt est devenu le programme
Novembre 2017, billet fondateur : « Software 2.0 s’écrit dans un langage beaucoup plus abstrait et hostile à l’humain, comme les poids d’un réseau de neurones ». Juin 2025, suite logique : « on programme désormais les ordinateurs en anglais ». Le prompt — la consigne en langage courant donnée au modèle — est devenu la couche de programmation. Entre la question d’un internaute et votre page, il y a donc un texte que personne n’audite, écrit par l’éditeur du moteur.
Ce que Karpathy dit qu’on ne sait pas encore faire
13. Les juges automatiques sont piratables
Octobre 2025, sur les modèles chargés de noter d’autres modèles : ce sont « des trucs géants avec des milliards de paramètres, et ils sont piratables ». Le modèle évalué finit par « trouver toutes ces choses parasites dans les moindres recoins » — des exemples adverses, des entrées absurdes qui décrochent la meilleure note. En avril 2026, sa parade reste prudente : « un conseil de juges LLM » donnerait probablement quelque chose de raisonnable. Conséquence : un outil qui note votre visibilité IA en interrogeant un modèle mesure un juge piratable. Lisez le protocole avant le score, comme pour le second classement.
14. Il passe beaucoup de temps sur « comment garder l’IA en laisse »
Juin 2025, formulation exacte : une grande part de sa réflexion porte sur « comment garder l’IA en laisse ». Ce n’est pas une consigne qu’il donne, c’est un problème de conception qu’il pose — et son exemple est simple : si la consigne est vague, l’IA peut ne pas faire exactement ce qu’on voulait. Il parle de code, la mécanique vaut pour un texte : plus la boucle production-vérification est courte, moins l’écart s’installe.
15. Il a relativisé son propre « vibe coding »
Février 2025, il invente le terme le plus repris de l’année : coder « en se laissant porter par l’ambiance, en oubliant que le code existe ». Un an plus tard, il en rabat trois fois. Il qualifie son message d’origine de « déluge de pensées lancé en l’air ». Il rappelle qu’à l’époque les modèles étaient assez faibles pour qu’on réserve le procédé à « des projets jetables, des démos et des explorations ». Et il change de mot : son favori du moment est « agentic engineering », l’ingénierie d’agents — « engineering » pour souligner qu’il y a là « un art, une science et une expertise ». À Sequoia il pose le partage : le vibe coding « relève le plancher de ce que chacun peut faire », l’ingénierie d’agents « préserve le niveau de qualité qui existait avant ». C’est l’argument de tout l’article : le terme qui sert aujourd’hui à justifier la publication sans relecture n’a jamais désigné ça, et son auteur passe son temps à le préciser.
Ce qui est documenté, ce qui est déduit
Six statuts servent dans cette série, plus un septième introduit ici : Opinion d’auteur, pour ce que Karpathy juge et qui n’est pas un mécanisme.
| Affirmation | Statut | Source |
|---|---|---|
| La tokenization explique une part des défauts des modèles, dont la moindre performance hors anglais | Documenté | Karpathy, dépôt minbpe, février 2024 |
| Halluciner est le régime normal d’un modèle de langage | Documenté | Karpathy, 9 décembre 2023 |
| La fenêtre de contexte tient le rôle de la mémoire de travail | Documenté | Karpathy, juin 2025 et 20 avril 2026 |
| Les modèles souffrent d’une amnésie antérograde | Documenté | Karpathy, juin 2025 et 17 octobre 2025 |
| L’intelligence des modèles est dentelée | Documenté | Karpathy, 25 juillet 2024 |
| « L’apprentissage par renforcement, c’est terrible » — mais meilleur que tout ce qui précédait | Opinion d’auteur | Karpathy, 17 octobre 2025 |
| Les sorties d’un modèle ont une distribution effondrée | Documenté | Karpathy, 17 octobre 2025 |
| Les modèles sont « des simulations stochastiques de personnes » | Documenté | Karpathy, juin 2025 |
| Il existe une nouvelle catégorie de consommateur d’information numérique, entre l’humain et l’interface | Documenté | Karpathy, juin 2025 |
| Que cette catégorie soit un « destinataire » de votre page, et ce que ça change au classement | Déduit | Aucune : Karpathy ne traite pas du référencement |
| 57,5 % des requêtes HTTP vers du HTML sont automatisées, tous robots confondus, sans ventilation IA | Observé | Cloudflare Radar, relevé du 3 juin 2026 |
| Les documentations écrites pour des humains sont un problème pour les agents | Opinion d’auteur | Karpathy, 20 avril 2026 |
Un fichier llms.txt peut aider les modèles |
Opinion d’auteur | Karpathy, juin 2025 |
97 % des llms.txt publiés n’ont reçu aucune requête en mai 2026 |
Observé | Ahrefs, 137 210 domaines suivis, publié le 15 juin 2026 |
Google Search ignore les fichiers llms.txt et assimilés |
Documenté | Google Search Central, mise à jour du 10 juillet 2026 |
| Les modèles qui notent d’autres modèles sont piratables par des exemples adverses | Documenté | Karpathy, 17 octobre 2025 |
| « Agentic engineering » est son terme favori du moment, à la place de « vibe coding » | Opinion d’auteur | Karpathy, février 2026 ; Sequoia, 20 avril 2026 |
Deux questions fréquentes
Faut-il publier un fichier llms.txt ?
La mesure de mai 2026 donne 97 % de ces fichiers sans une seule requête, et Google écrit noir sur blanc que Search les ignore. Le coût est faible, le bénéfice mesuré proche de zéro tant qu’aucun lien ni aucune consigne ne les signale. Ce qui a un effet, c’est que la page elle-même soit lisible : titres explicites, phrases courtes, informations clés en haut.
Écrire pour les modèles, est-ce écrire pour les moteurs de recherche ? Non, et c’est le point qui gêne. La recherche classique classe des pages ; un modèle fabrique un résumé à partir d’un extrait, dans une fenêtre partagée avec tout le reste. Le critère change : être court, daté et attribuable compte plus qu’être bien placé.
Ce qu’il faut en retenir
Karpathy situe l’informatique par modèles « dans les années 1960 », quand le calcul était encore cher et partagé. Deux choses en découlent pour un site. Un : ce qui est devenu abondant, c’est la production de texte ; ce qui est devenu rare, c’est la vérification. Deux : les robots pèsent déjà plus lourd que les humains dans les requêtes, mais ils ne vont pas chercher les fichiers écrits pour eux — ils lisent les pages.
Sources
- Andrej Karpathy, Software 2.0, 11 novembre 2017 — karpathy.medium.com
- Andrej Karpathy, sur le problème de l’hallucination, 9 décembre 2023 — repris par simonwillison.net
- Andrej Karpathy, minbpe — Let’s build the GPT Tokenizer, février 2024 — github.com
- Andrej Karpathy, Jagged Intelligence, 25 juillet 2024 — repris par marktechpost.com
- Andrej Karpathy, Software Is Changing (Again), AI Startup School de Y Combinator, juin 2025 — transcription sur singjupost.com
- Andrej Karpathy, entretien avec Dwarkesh Patel, 17 octobre 2025 — dwarkesh.com
- Andrej Karpathy, du vibe coding à l’agentic engineering, février 2026 — rapporté par thenewstack.io
- Andrej Karpathy, LLM Wiki, note publique du 4 avril 2026 — présentée par denser.ai
- Andrej Karpathy, entretien avec Stephanie Zhan, Sequoia AI Ascent, 20 avril 2026 — transcription sur singjupost.com, date de l’événement confirmée sur sequoiacap.com
- Ahrefs, We Analyzed 137K Sites: 97 % of llms.txt Files Never Get Read, 15 juin 2026 — ahrefs.com
- Cloudflare Radar, part du trafic automatisé, relevé du 3 juin 2026 — rapporté par techtimes.com
- Google Search Central, AI optimization guide, mise à jour du 10 juillet 2026 — developers.google.com