
« Le contenu dupliqué est pénalisé » est une phrase que tout le monde répète et que personne ne source. Google répond depuis dix ans qu’il n’existe pas de pénalité pour contenu dupliqué, sans jamais décrire ce qui est mesuré à la place. La documentation interne rendue publique en 2024 nomme trois mécanismes distincts, et aucun des trois ne ressemble à une pénalité.
Le score d’originalité n’existe que sur les pages pauvres
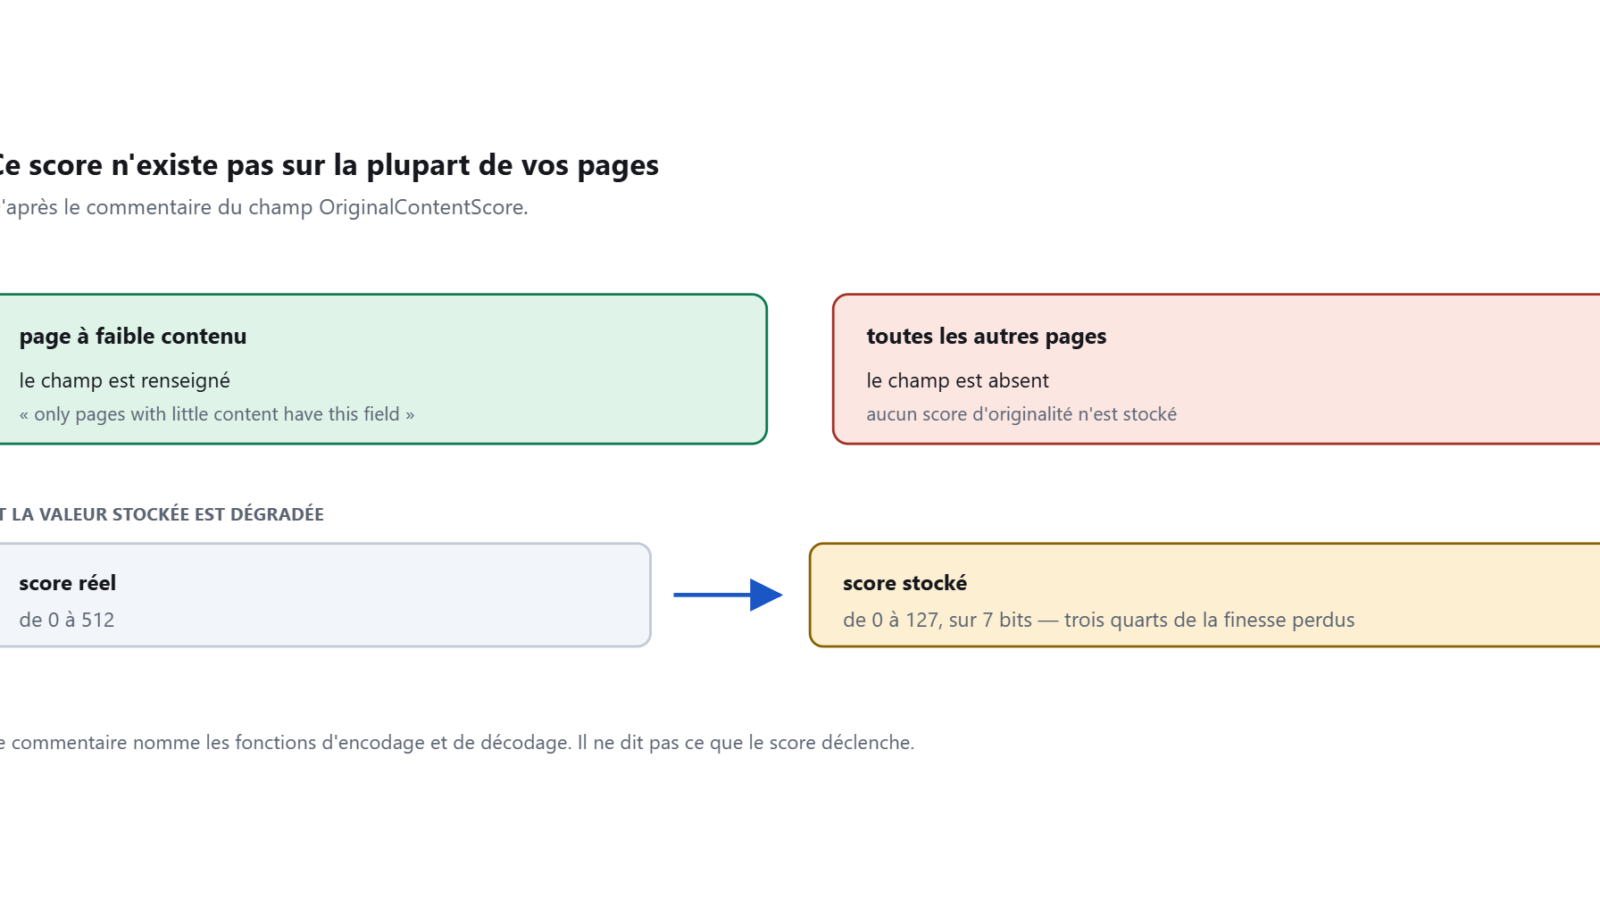
PerDocData.OriginalContentScore est cité partout comme « le score d’originalité de Google ». Son commentaire dit autre chose, et il faut le lire en entier :
« The original content score is represented as a 7-bits, going from 0 to 127. Only pages with little content have this field. The actual original content score ranges from 0 to 512. It is encoded with quality_q2::OriginalContentUtil::EncodeOriginalContentScore(). » — le score est représenté sur 7 bits, de 0 à 127 ; seules les pages à faible contenu ont ce champ ; le score réel, lui, va de 0 à 512 ; il est encodé par une fonction dédiée.
Trois choses, dans l’ordre d’importance.
La restriction est la moitié du sujet. Ce n’est pas une note d’originalité attribuée à tout le web : c’est un champ qui n’existe que sur les pages courtes. Le système cherche à distinguer une page brève qui apporte quelque chose d’une page brève qui recopie. Sur une page longue, ce champ est absent.
La valeur stockée est une version dégradée de la valeur calculée. De 0-512 vers 0-127 : trois quarts de la finesse sont perdus au profit de la place. Le score réel existe donc quelque part, et ce n’est pas celui qui est conservé ici.
Le commentaire nomme les fonctions d’encodage et de décodage, ce qui est rare. Il ne dit rien de ce qui déclenche le champ, ni de ce que le score change.
Google garde deux empreintes de votre page, dont une sans l’habillage
Voici le mécanisme le plus concret du dossier, et il est presque jamais cité. Deux champs voisins, deux empreintes de la même page.
CompositeDoc.ContentChecksum96 : « Visible content checksum as computed by […] Checksum96bitsParseHandler. » — empreinte du contenu visible, calculée par un composant dédié.
CompositeDocAdditionalChecksums.NoTransientChecksum96 : « Same as ContentChecksum96 but without transient boilerplate. » — la même empreinte, sans l’habillage transitoire.
Lisez la seconde ligne lentement. Google calcule une empreinte de votre page en excluant l’habillage — l’en-tête, le menu, la barre latérale, le pied de page, tout ce qui se répète d’une page à l’autre et change avec le gabarit.
Ce que ça établit. Le système sait séparer, sur une page, ce qui est du gabarit et ce qui est du contenu. Et il conserve les deux empreintes, pas une seule.
Ce que ça implique, et c’est une déduction. Deux pages qui partagent le même gabarit mais pas le même texte ont la même structure d’habillage et deux empreintes sans habillage différentes. À l’inverse, changer son menu ne change pas l’empreinte sans habillage. Le commentaire ne dit pas à quoi servent ces empreintes ; il dit seulement qu’elles existent, et qu’il y en a deux.
Un champ s’appelle littéralement « copieur », et il n’a aucun commentaire
BlogPerDocData.copycatScore. Un score de copieur. Aucun commentaire.
C’est tout ce qu’il y a, et c’est exactement l’exemple du piège qu’il faut nommer : le nom est éloquent, le dépôt est muet. On sait que le champ existe, dans une structure propre aux blogs. On ne sait ni ce qu’il mesure, ni comment, ni ce qu’il déclenche.
Même remarque pour GDocumentBase.originalcontent, nommé sans une ligne d’explication.
La méta-description dupliquée est tracée, et une page est désignée « racine »
Dernier mécanisme, et il porte sur un objet précis. WWWDocInfo.rootpageDuplicateMetadescription : « True if the meta-description is duplicated on many other pages and this page is the rootpage of such pages which have the same meta-description. » — vrai si la méta-description est dupliquée sur beaucoup d’autres pages et que cette page-ci est la page racine de ce groupe.
Deux informations dans une phrase. La duplication des méta-descriptions est repérée à l’échelle d’un groupe de pages, et parmi ces pages, une est désignée comme la racine. Le champ est un booléen porté par cette page-là.
Un second champ, IndexingDocjoinerDataVersion.qualitySnippetsMetadescriptionDuplicateMetaSiteSignal, indique qu’un signal de site existe sur le même sujet — sans aucun commentaire.
Ce que le commentaire ne dit pas : combien fait « beaucoup », comment la racine est choisie, et ce que le booléen change.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Le champ d’originalité n’existe que sur les pages à faible contenu | Documenté | Commentaire de OriginalContentScore |
| La valeur stockée est compressée de 0-512 vers 0-127, sur 7 bits | Documenté | Idem |
| Une empreinte du contenu visible de la page est conservée | Documenté | Commentaire de ContentChecksum96 |
| Une seconde empreinte est conservée, sans l’habillage transitoire | Documenté | Commentaire de NoTransientChecksum96 |
| Le système sait donc distinguer le gabarit du contenu sur une page | Déduit | Conséquence directe de l’existence des deux empreintes |
| La duplication de méta-description est repérée par groupe, avec une page racine désignée | Documenté | Commentaire de rootpageDuplicateMetadescription |
Un champ copycatScore existe dans la structure propre aux blogs |
Documenté | Le champ est nommé |
copycatScore et originalcontent n’ont aucun commentaire |
Mesuré | Relevé des commentaires du dépôt |
| « Google note l’originalité de toutes vos pages » | Faux | Le champ ne concerne que les pages à faible contenu |
| « Le contenu dupliqué est pénalisé » | Non documenté | Aucun champ du dépôt ne décrit de pénalité pour duplication |
Ce que copycatScore mesure |
Non documenté | Le nom est éloquent, le dépôt est muet |
| À quoi servent les deux empreintes | Non documenté | Leur existence est écrite, leur usage ne l’est pas |
| Le seuil de « beaucoup d’autres pages » pour une méta-description | Non documenté | Aucun chiffre |
Limites de cet article. Le dépôt décrit l’état d’un système interne au premier trimestre 2024 et n’a pas été mis à jour depuis : rien ne garantit que ces champs soient encore renseignés aujourd’hui. Aucun des commentaires cités ne décrit un effet sur le classement.
Questions fréquentes
Republier un texte sur deux de mes pages est-il risqué ? Ces documents ne décrivent aucune sanction pour ce cas. Ils établissent qu’une empreinte du contenu visible existe, qu’une seconde ignore l’habillage, et qu’un champ d’originalité s’applique aux pages courtes. Ce que le système en fait n’est écrit nulle part.
Une fiche produit courte est-elle concernée par le score d’originalité ? Le commentaire dit « seules les pages à faible contenu ont ce champ », sans définir le seuil. Une fiche produit courte entre plausiblement dans cette catégorie, mais aucun texte ne le confirme.
Faut-il des méta-descriptions uniques ? Un champ repère explicitement les méta-descriptions dupliquées sur beaucoup de pages et désigne une page racine dans le groupe. Le mécanisme existe donc. Ce qu’il déclenche n’est documenté ni dans le dépôt ni dans les sources publiques de Google.
Changer mon menu ou mon pied de page modifie-t-il ce que Google voit ? Une des deux empreintes est calculée sans l’habillage transitoire : par construction, elle ne bouge pas quand seul le gabarit change. L’autre, celle du contenu visible, inclut ce qui est affiché. Les documents ne disent pas laquelle est utilisée pour quoi.
Sources
- Miroir public du client Elixir ContentWarehouse, instantané du 27 mars 2024 — sur github.com