
Le conseil circule partout : « ne dépassez pas 10 % d’ancres optimisées ». Personne ne dit d’où sort le chiffre, et pour cause — aucune source publique de Google ne le donne. La documentation interne rendue publique en 2024 décrit bien une mécanique de détection des ancres abusives, mais elle ne ressemble pas du tout à un pourcentage. Elle ressemble à une courbe.
Ce que Google conserve autour d’un lien
Avant la sur-optimisation, il faut voir ce qui est stocké. Un lien n’est pas réduit à son texte : la structure qui le décrit contient plusieurs champs autour de lui.
text : « Space-delimited anchor words. » — les mots de l’ancre, séparés par des espaces. origText : « Original text, including capitalization and punctuation. » — le texte d’origine, majuscules et ponctuation comprises. Les deux coexistent : la version normalisée et la version telle qu’écrite.
Vient ensuite ce que presque personne ne mentionne. context2 : « This is a hash of terms near the anchor. » — une empreinte des termes situés près du lien. Et deux champs fullLeftContext et fullRightContext, décrits comme « The full context. » — le contexte complet, à gauche et à droite.
Le texte autour du lien est conservé, pas seulement le texte du lien. C’est la conséquence la plus directement utile de cette section : soigner l’ancre sans soigner la phrase qui la porte revient à ne traiter qu’une partie de ce qui est stocké.
Un dernier champ, fontsize, est nommé sans aucun commentaire. La taille de police du lien est conservée ; ce qu’on en fait n’est écrit nulle part.
Le décalage entre l’ancre et la page est un champ de démotion
CompressedQualitySignals.anchorMismatchDemotion : « anchor_mismatch_demotion: converted from QualityBoost.mismatched.boost. » — une démotion liée à un décalage d’ancre, convertie depuis un autre protocole, et donc logée sur les mêmes dix bits que les autres signaux de cette structure.
Le nom donne le principe : quelque chose se déclenche quand le texte du lien ne correspond pas à la page visée. Le commentaire ne dit ni ce que « décalage » recouvre, ni à partir de quel écart, ni ce que la démotion retire.
Ce que Google écrit publiquement sur le sujet est plus utilisable, et va dans le même sens : « Good anchor text is descriptive, reasonably concise, and relevant to the page that it’s on and to the page it links to. » — un bon texte d’ancre est descriptif, raisonnablement concis, et pertinent pour la page où il se trouve comme pour celle vers laquelle il pointe. Noter la double exigence : pertinent pour les deux pages. La mise en pratique est traitée dans la méthode de maillage interne en cinq étapes.
La sur-optimisation n’est pas un pourcentage, c’est un pic
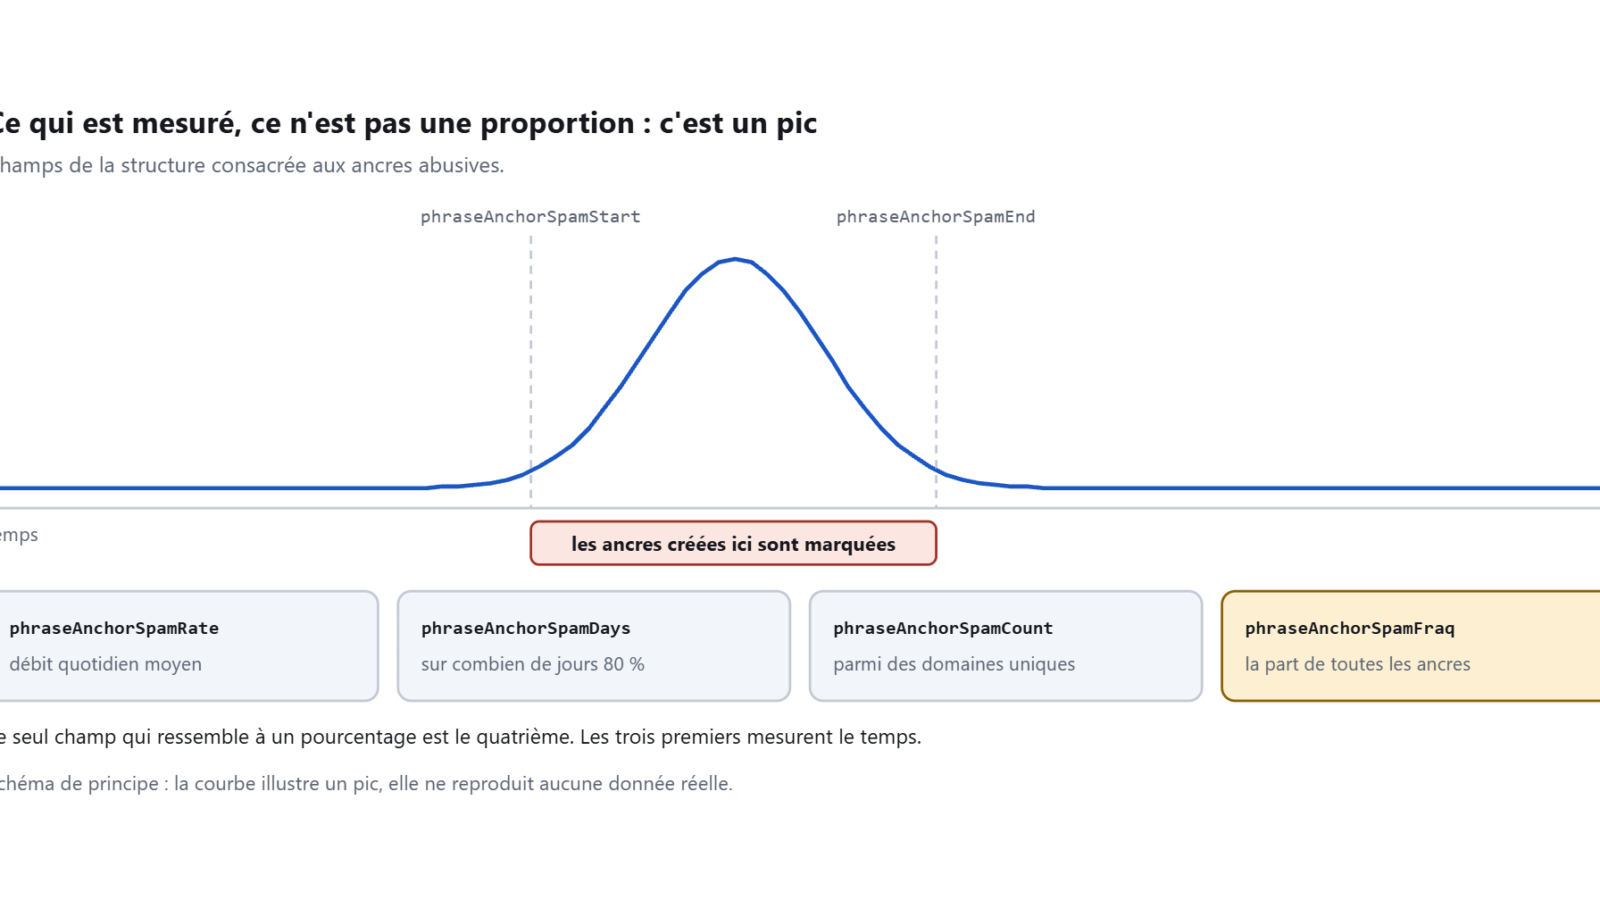
Voici le cœur du sujet, et il contredit frontalement le conseil des 10 %. Une structure entière, IndexingDocjoinerAnchorPhraseSpamInfo, est consacrée à la détection des ancres abusives — et ses champs sont presque tous temporels.
Le commentaire qui chapeaute l’ensemble donne l’intention : « Following signals identify spike of spammy anchor phrases. Anchors created during the spike are tagged with LINK_SPAM_PHRASE_SPIKE. » — les signaux suivants identifient un pic de phrases d’ancre abusives ; les ancres créées pendant le pic sont marquées d’une étiquette dédiée.
Les champs, un par un.
phraseAnchorSpamStart et phraseAnchorSpamEnd : « Time when anchor spam spike started » et « ended with padding » — le moment où le pic commence et celui où il se termine, avec une marge.
phraseAnchorSpamRate : « Average daily rate of spam anchor discovery. » — le débit quotidien moyen de découverte d’ancres abusives.
phraseAnchorSpamDays : « Over how many days 80% of these phrases were discovered. » — sur combien de jours 80 % de ces expressions ont été découvertes. C’est une mesure de concentration dans le temps.
phraseAnchorSpamCount : « How many spam phrases found in the anchors among unique domains. » — combien d’expressions abusives trouvées, parmi des domaines uniques.
phraseAnchorSpamFraq : « Spam phrases fraction of all anchors of the document. » — la fraction que ces expressions représentent dans l’ensemble des ancres du document. C’est le seul champ de la structure qui ressemble à un pourcentage, et il arrive après quatre mesures temporelles.
phraseAnchorSpamPenalty : « Combined penalty for anchor demotion. » — la pénalité combinée. phraseAnchorSpamDemoted et phraseAnchorSpamProcessed : le nombre d’ancres démotées et le nombre d’ancres observées.
Ce que ça établit. Le mécanisme décrit ne regarde pas un état, il regarde une dynamique : quand, pendant combien de temps, à quel débit, depuis combien de domaines distincts. La proportion n’est qu’un champ parmi neuf.
Ce sont les ancres du pic qui sont marquées, pas forcément le site
La phrase la plus importante du dossier tient en une ligne, et elle change la lecture de tout le reste : « Anchors created during the spike are tagged. » — les ancres créées pendant le pic sont marquées. Ce sont les ancres qui reçoivent l’étiquette, pas la page ni le site.
Un champ voisin décrit ce qui arrive quand une page est bien pénalisée. IndexingDocjoinerAnchorStatistics.badbacklinksPenalized : « Whether this doc is penalized by BadBackLinks, in which case we should not use improvanchor score in mustang ascorer. » — si ce document est pénalisé au titre des mauvais liens entrants, auquel cas le score d’amélioration par les ancres ne doit pas être utilisé.
Lisez la formulation : la sanction décrite consiste à ne pas bénéficier de l’apport des ancres, pas à retrancher quelque chose. Ne plus gagner et perdre ne sont pas la même opération, et c’est la première qui est écrite.
Une dernière précision de vocabulaire : la structure phraseAnchorSpamInfo est déclarée dépréciée, remplacée par anchorSpamInfo, dont le commentaire dit seulement qu’elle « contains signals and penalties of AnchorSpamPenalizer » — contient les signaux et pénalités d’un pénaliseur d’ancres abusives. La structure qui remplace est donc moins documentée que celle qu’elle remplace.
Cet article détaille un point du chapitre sur les liens et la popularité. Voir aussi ce que vaut un nom de domaine.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
| Le texte de l’ancre est stocké en deux versions, normalisée et d’origine | Documenté | Commentaires de text et origText |
| Une empreinte des termes proches du lien est conservée | Documenté | Commentaire de context2 |
| Le contexte complet, à gauche et à droite du lien, est conservé | Documenté | Commentaires de fullLeftContext et fullRightContext |
Un champ anchorMismatchDemotion existe |
Documenté | Commentaire du champ |
| Un bon texte d’ancre est pertinent pour la page qui le porte et pour la page visée | Documenté | Google Search Central, Link best practices, maj 10/12/2025 |
| La détection des ancres abusives repose sur l’identification d’un pic | Documenté | Commentaire de phraseAnchorSpamInfo |
| Le début, la fin, le débit quotidien et la concentration du pic sont stockés | Documenté | Commentaires des champs de IndexingDocjoinerAnchorPhraseSpamInfo |
| Le compte se fait parmi des domaines uniques | Documenté | Commentaire de phraseAnchorSpamCount |
| Les ancres créées pendant le pic sont marquées d’une étiquette dédiée | Documenté | Commentaire de phraseAnchorSpamInfo |
| La sanction décrite consiste à ne pas utiliser l’apport des ancres | Documenté | Commentaire de badbacklinksPenalized |
fontsize est stocké sans aucun commentaire |
Mesuré | Relevé des commentaires du dépôt |
| La détection porte d’abord sur une dynamique, pas sur une proportion | Déduit | Huit champs sur neuf de la structure sont temporels ou de comptage |
| « Il ne faut pas dépasser 10 % d’ancres optimisées » | Non documenté | Aucun seuil, dans aucun champ ni aucune source publique de Google |
| À partir de quel débit un pic est détecté | Non documenté | Les champs mesurent, aucun ne donne de seuil |
| Ce que « décalage » recouvre pour une ancre | Non documenté | Le champ est nommé, jamais défini |
Limites de cet article. Le dépôt décrit l’état d’un système interne au premier trimestre 2024 et n’a pas été mis à jour depuis. La structure la plus détaillée sur les ancres abusives y est déjà déclarée dépréciée, remplacée par une structure au commentaire bien plus court : ce qui est décrit ici est donc, de l’aveu même du dépôt, un état antérieur du mécanisme.
Questions fréquentes
Quelle proportion d’ancres optimisées ne pas dépasser ? Aucun chiffre n’est donné nulle part. Un champ mesure bien la fraction que représentent les expressions abusives dans l’ensemble des ancres d’un document, mais il ne porte aucun seuil, et il arrive après quatre mesures de temps.
Le négative SEO fonctionne-t-il ? Ces documents décrivent un mécanisme qui repère une arrivée massive et concentrée d’ancres abusives et marque celles du pic. Cette construction est cohérente avec l’idée de neutraliser un afflux artificiel plutôt que de sanctionner sa cible. Les documents ne le disent pas en ces termes, et ne garantissent aucun résultat.
Faut-il varier ses ancres ? Rien dans ces champs ne prescrit la variété. Ce qu’ils indiquent, c’est que la répétition d’une même expression, sa vitesse d’apparition et le nombre de domaines distincts concernés sont mesurés ensemble. La lecture prudente est que le rythme compte autant que le contenu.
Mes ancres internes sont-elles concernées ?
La structure décrite porte sur les ancres d’un document sans distinguer explicitement l’origine. Un autre champ, isLocal, marque à part les liens dont la source et la cible sont sur le même domaine. Aucun commentaire ne dit si la détection de pic les traite différemment.
Sources
- Miroir public du client Elixir ContentWarehouse, instantané du 27 mars 2024 — sur github.com
- Google Search Central, Link best practices for Google, mise à jour du 10 décembre 2025 — sur developers.google.com