
Vous lisez qu’il faut « travailler son taux de clic pour remonter », et juste après qu’un porte-parole de Google explique que les clics ne sont pas un facteur de classement. Les deux affirmations circulent depuis dix ans, souvent dans le même article. Deux corpus publics permettent de trancher une partie de la question : la documentation interne rendue publique en 2024, et les constatations du juge dans le procès antitrust américain. Cet article expose ce que chacun des deux établit exactement, ce qu’ils confirment ensemble — et les trois points qu’aucun des deux ne donne.
Ce que le dépôt nomme, et ce qu’il n’explique pas
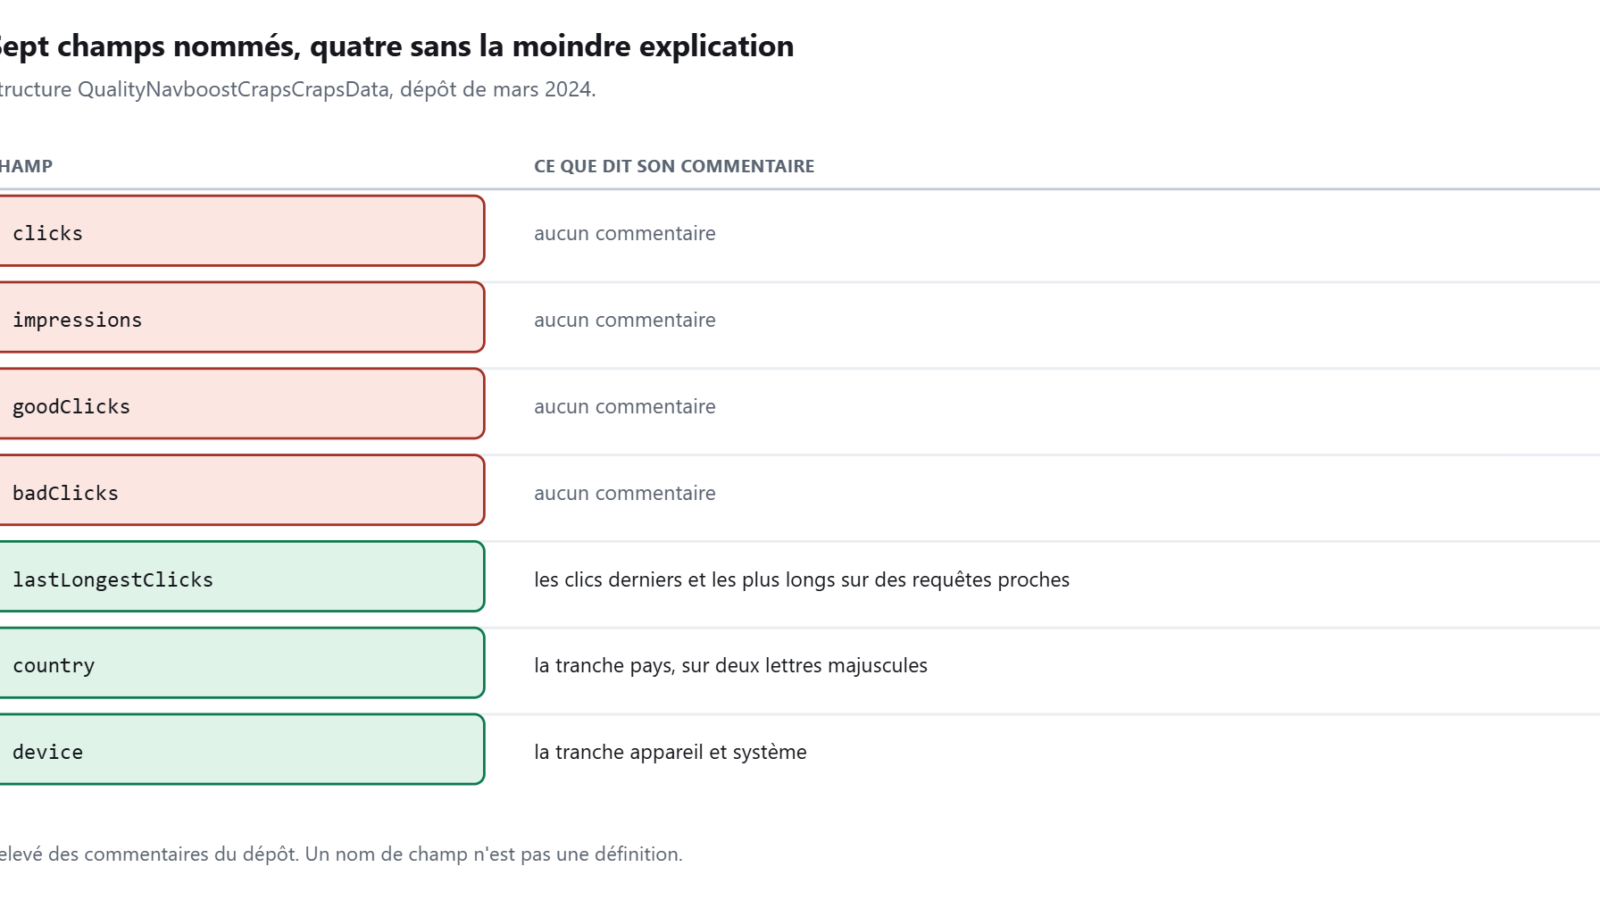
La documentation interne publiée par erreur en 2024 décrit des structures de données. Sur les clics, elle nomme une structure QualityNavboostCrapsCrapsData qui contient six champs, et c’est là que commence la nuance que personne ne relève.
Quatre de ces champs — clicks, goodClicks, badClicks, impressions — sont nommés sans le moindre commentaire. Leur intitulé est tout ce qu’on a. « Bon clic » et « mauvais clic » sont des mots que Google emploie dans son code, pas des notions qu’il définit publiquement.
Deux champs portent en revanche un commentaire d’ingénieur, et ce sont les plus instructifs. lastLongestClicks : « The number of clicks that were last and longest in related user queries. » — le nombre de clics qui ont été les derniers et les plus longs sur des requêtes proches. Et, dans une structure voisine, unicornClicks : « The subset of clicks that are associated with an event from a Unicorn user. » — le sous-ensemble des clics associés à un événement provenant d’un utilisateur « licorne ».
Le détail du mécanisme de reclassement est traité dans l’article consacré à NavBoost, et le dispositif technique qui enregistre le clic avant de vous envoyer sur le site est décrit dans celui sur google.com/goto.
Ce que le procès a établi sous serment
Le 5 août 2024, le juge Amit Mehta a rendu une décision contenant des constatations de fait numérotées. La constatation n° 96 décrit le système : « Navboost is another signal that pairs queries and documents through memorizing user click data. » — Navboost est un signal qui apparie requêtes et documents en mémorisant les données de clic des utilisateurs.
La même constatation donne la fenêtre : « Prior to 2017, Google trained Navboost on 18 months of user data. Since then, it has trained Navboost on 13 months of user data. » — avant 2017, Google entraînait Navboost sur 18 mois de données ; depuis, sur 13 mois.
Attention à ce que ces 13 mois désignent. C’est la fenêtre de données sur laquelle Navboost est entraîné, pas une politique de conservation des données chez Google. La même fenêtre vaut d’ailleurs pour QBST, un autre signal décrit à la constatation n° 95.
Et le juge cite, à la constatation n° 102, une pièce interne versée au dossier sous la cote UPX190, pour établir que les systèmes fondés sur les grands modèles de langage n’ont pas remplacé Navboost : « Navboost remains one of the most power ranking components historically » [sic] — Navboost reste historiquement l’un des composants de classement les plus puissants.
Le point où les deux corpus se recoupent
C’est l’apport le plus solide du dossier, et il passe inaperçu parce qu’il porte sur un détail d’apparence technique : le découpage des données.
Interrogé le 18 octobre 2023, Pandu Nayak, vice-président chargé de la recherche, a décrit sous serment un découpage par zone géographique et par type d’appareil. Le dépôt le confirme, champ par champ. QualityNavboostCrapsCrapsData.country : « The two-letter uppercase country slice of the CrapsData. Examples: « US », « FR », « BR » » — la tranche pays, sur deux lettres majuscules. QualityNavboostCrapsCrapsData.device : « The device interface and os slice of the CrapsData. » — la tranche appareil. Une structure voisine précise même les valeurs : « « m » – mobile devices. « d » – destop devices. » [sic].
Un témoignage sous serment et une documentation interne, produits indépendamment, décrivent le même découpage. C’est le plus haut degré de confirmation disponible sur ce sujet.
Conséquence concrète, et elle est rarement tirée : les clics ne sont pas mémorisés dans un pot commun mondial. Ce qui se passe sur mobile en France et ce qui se passe sur ordinateur aux États-Unis sont, au moins pour ce mécanisme, deux jeux de données distincts.
Ce que Chrome apporte, et jusqu’où on peut le dire
Un champ du dépôt s’appelle QualityNsrNsrData.chromeInTotal, et son commentaire tient en trois mots : « Site-level Chrome views. » — vues Chrome au niveau du site.
C’est court, et c’est tout ce qu’il y a. Le champ existe, il est au niveau du site et non de la page, et il compte des vues issues du navigateur. Rien dans le dépôt ni dans le procès ne dit quel poids il a, ni même s’il est renseigné en production. Entre « un champ nommé chromeInTotal existe » et « Google se sert de Chrome pour classer les sites », il y a une marche que ces documents ne franchissent pas.
Cet article est un chapitre du dossier sur ce que ces documents changent concrètement pour un site. Le chapitre voisin traite la question de l’autorité d’un site et de ses liens.
Ce qui est documenté, ce qui est déduit, ce qui reste inconnu
| Affirmation | Statut | Source |
|---|---|---|
Une structure QualityNavboostCrapsCrapsData existe, avec des champs de clic nommés |
Documenté | Dépôt de mars 2024 |
clicks, goodClicks, badClicks et impressions n’ont aucun commentaire |
Mesuré | Relevé des commentaires du dépôt |
lastLongestClicks compte les clics « derniers et les plus longs » sur des requêtes proches |
Documenté | Commentaire du champ |
| Les données sont découpées par pays et par type d’appareil | Documenté deux fois | Commentaires des champs country et device ; témoignage Nayak du 18/10/2023 |
| Navboost apparie requêtes et documents en mémorisant les clics | Documenté | Opinion Mehta, 05/08/2024, constatation n° 96 |
| La fenêtre est de 13 mois, 18 avant 2017 | Documenté | Idem, constatation n° 96 |
| « Navboost reste l’un des composants de classement les plus puissants » | Documenté | Pièce UPX190, citée à la constatation n° 102 |
chromeInTotal compte des vues Chrome au niveau du site |
Documenté | Commentaire du champ |
| « Google conserve 13 mois de données de clic » | Imprécis | Les 13 mois sont la fenêtre d’entraînement de Navboost, pas une politique de rétention |
| « Les clics sont le premier facteur de classement » | Non documenté | Aucune phrase du juge ni de Nayak ne hiérarchise ainsi les signaux |
| Ce que Google appelle exactement un bon ou un mauvais clic | Non documenté | Les champs sont nommés, jamais définis |
| Le poids des clics dans le classement | Non documenté | Ni le dépôt ni le procès ne le donnent |
Limites de cet article. Le dépôt décrit l’état d’un système interne au premier trimestre 2024 et n’a pas été mis à jour depuis. Les pièces UPX190 et UPX196, qui décrivent Navboost, ne figurent pas parmi les documents publiés par le ministère de la Justice : elles n’ont été lues qu’à travers les fragments qu’en reproduit l’opinion. Enfin, les sections de l’opinion de septembre 2025 consacrées au partage des données d’interaction n’ont pas pu être consultées.
Questions fréquentes
Faut-il chercher à faire cliquer sur ses résultats ?
Un titre honnête vaut mieux qu’un titre qui fait cliquer et déçoit : le badClick est nommé dans les documents, et le mécanisme décrit au procès mémorise les deux sens. Fabriquer des clics est une autre affaire, sur laquelle aucun des deux corpus ne dit quoi que ce soit.
Pourquoi Google a-t-il dit pendant des années que les clics ne comptaient pas ? Les déclarations publiques de Google portent le plus souvent sur le fait que le taux de clic n’est pas un facteur direct et manipulable. Les documents décrivent un mécanisme de mémorisation, ce qui n’est pas exactement la même affirmation. Départager les deux relève de l’interprétation, pas des sources.
Un « clic long » compte-t-il plus qu’un clic court ?
Le champ lastLongestClicks existe et son commentaire parle bien des clics les plus longs. Ce qu’on ne sait pas, c’est ce que « long » veut dire en secondes, ni ce que ce champ pèse. Le nom d’un champ n’est pas une formule.
Mon site est petit, est-ce que ça me concerne ? Le découpage par pays et par appareil implique que les volumes sont fractionnés. Sur une requête peu recherchée, le mécanisme dispose de très peu de données — mais aucune source publique ne donne de seuil en dessous duquel il cesse d’opérer.
Sources
- Opinion du juge Amit Mehta, United States v. Google LLC, n° 20-cv-3010, 5 août 2024 — constatations de fait n° 95, 96 et 102 — sur courtlistener.com
- Transcription d’audience du 18 octobre 2023, témoignage de Pandu Nayak — sur thecapitolforum.com
- Miroir public du client Elixir ContentWarehouse, instantané du 27 mars 2024 — sur github.com