
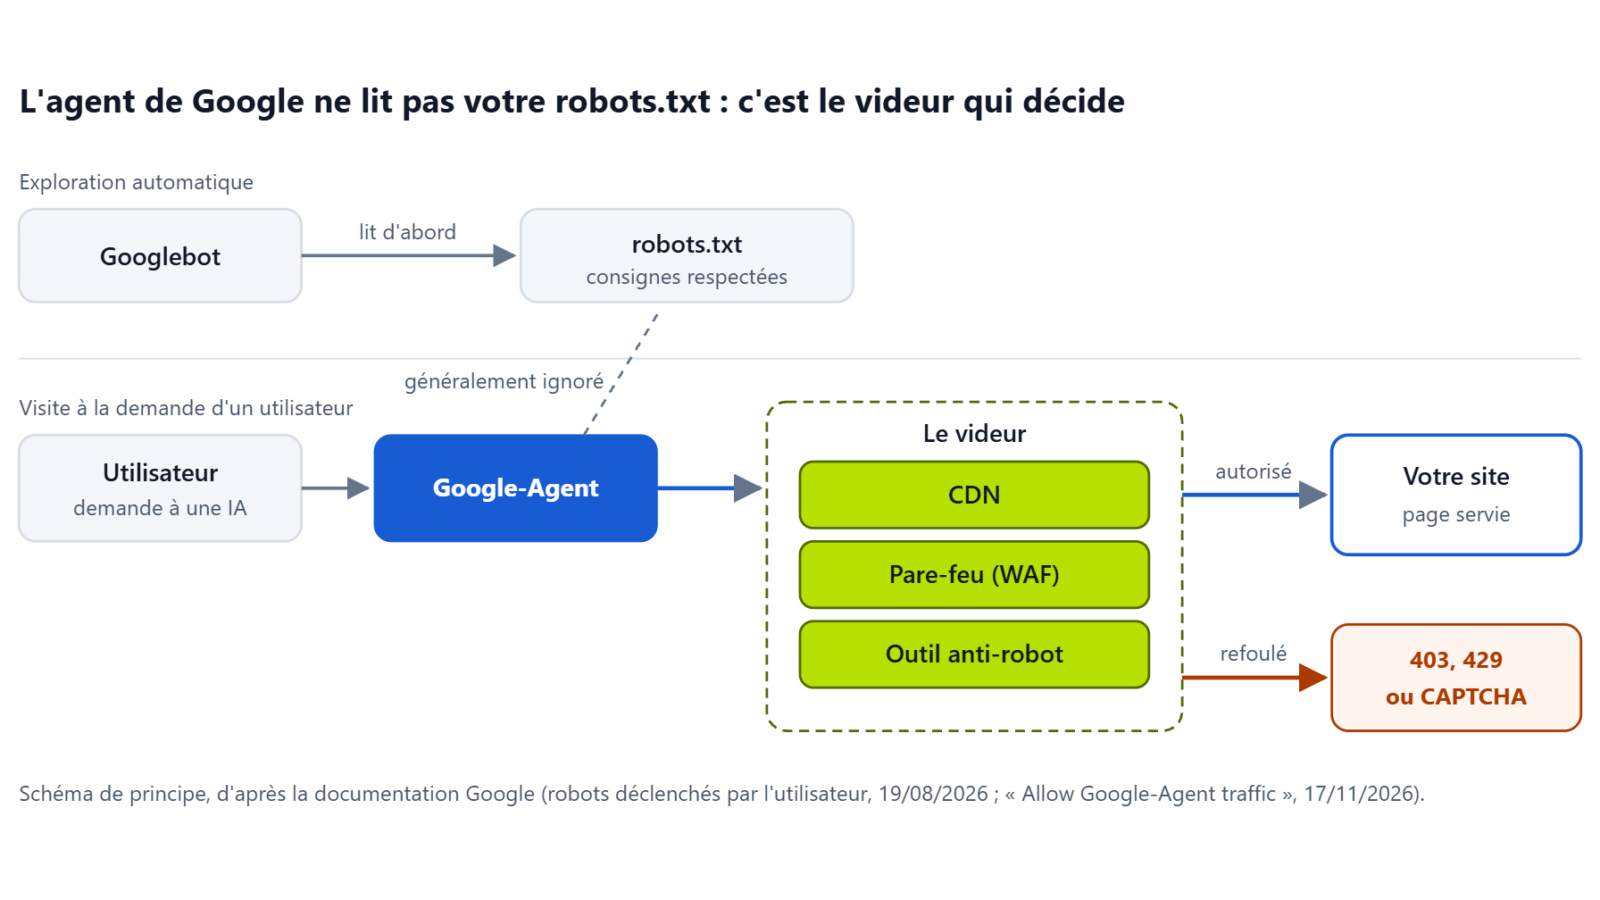
On vous dit d’ouvrir votre site à l’agent IA de Google. Ça ne se règle pas dans le robots.txt, le fichier de consignes pour robots, que cet agent ignore généralement : c’est le « videur » placé devant votre site, pare-feu ou réseau de diffusion, qui le laisse entrer ou le refoule. Vous trouverez ici comment savoir s’il est refoulé, et le message à envoyer à votre hébergeur. Pour régler vous-même le pare-feu, voyez plutôt la documentation de votre fournisseur.
L’essentiel
- Google-Agent est le robot qui navigue et agit sur votre site quand un utilisateur le demande à une IA de Google.
- Il ignore généralement le robots.txt : ce qui peut le bloquer, c’est le pare-feu, le réseau de diffusion ou l’outil anti-robot placé devant votre site.
- Un vrai Google-Agent se reconnaît à deux preuves (son nom et une adresse IP publiée par Google), plus une signature numérique présente sur une partie seulement des visites.
- Demandez à votre prestataire de l’autoriser avant les autres règles, sans CAPTCHA, sur tout le parcours : recherche, panier, réservation.
- Google ne dit ni quels services l’utilisent aujourd’hui, ni combien de visites il apporte.
À jour au 19 novembre 2026.
Votre site peut refouler l’agent de Google sans que vous le sachiez
L’agent IA de Google peut être bloqué par votre site même si votre robots.txt l’autorise, parce que le blocage se fait en amont, au niveau du pare-feu ou du réseau de diffusion.
Google-Agent est le robot que Google envoie quand un utilisateur demande à une de ses IA d’agir sur le web : consulter une page, comparer des produits, remplir un formulaire. Google le définit comme des agents « hosted on Google infrastructure to navigate the web and perform actions upon user request » (hébergés sur l’infrastructure de Google pour naviguer sur le web et effectuer des actions à la demande de l’utilisateur). Il figure dans la liste officielle des robots de Google depuis le 20 mars 2026, selon Search Engine Land. Google citait alors en exemple Project Mariner, son agent de navigation expérimental, fermé depuis.
Comme il agit pour une personne précise, il ne suit généralement pas les règles des robots d’indexation. Google l’écrit pour toute cette famille : « Because the fetch was requested by a user, these fetchers generally ignore robots.txt rules » (comme la récupération a été demandée par un utilisateur, ces robots ignorent généralement les règles du robots.txt). Le robots.txt est un panneau à l’entrée ; Google-Agent ne s’arrête généralement pas pour le lire.
Ce qui peut l’arrêter, c’est le videur. Sur beaucoup de sites professionnels, chaque visite traverse un ou plusieurs filtres avant d’atteindre le serveur :
- un CDN (réseau de diffusion de contenu, comme Cloudflare ou Akamai), qui sert les pages depuis des serveurs proches du visiteur et filtre au passage ;
- un WAF (pare-feu applicatif web), qui bloque les visites jugées dangereuses ;
- un outil anti-robot, qui trie humains et robots, souvent avec un CAPTCHA (le test « cochez les feux rouges »).
Ces filtres repoussent les robots inconnus, et un agent qui navigue vite depuis les serveurs d’un géant du cloud (ces entreprises qui louent des serveurs à la demande, comme Google, Amazon ou Microsoft) ressemble à ce qu’ils doivent arrêter. Le problème est mesuré pour d’autres agents : selon PPC Land, la société Blend a audité 200 sites marchands britanniques et américains, et la protection anti-robot bloquait son agent d’achat IA sur 29 d’entre eux (novembre 2026). Aucune mesure équivalente n’est publiée pour Google-Agent.
C’est pour cette raison que Google a publié, le 17 novembre 2026, une page qui demande d’autoriser explicitement son agent : cela « helps prevent legitimate requests from being blocked while preserving your existing security controls » (aide à éviter que des visites légitimes soient bloquées, tout en conservant vos protections existantes).
Ce type de blocage figure déjà dans les réglages proposés par un grand fournisseur. Depuis le 15 septembre 2026, Cloudflare propose à chaque nouveau site deux préréglages, « depending on whether the site earns money from advertising » (selon que le site gagne de l’argent grâce à la publicité) : pour un site qui en affiche, la catégorie Agent est réglée sur « Block on pages with ads » (bloquer sur les pages avec publicité). Le client peut changer ce réglage à tout moment. Cloudflare ne publie pas dans quelle catégorie il range Google-Agent. Si votre site passe par Cloudflare et affiche de la publicité, c’est le premier point à faire vérifier.
Robots.txt ou pare-feu : qui décide pour quel robot de Google
Google envoie trois sortes de visiteurs qui se règlent à deux endroits différents : Googlebot et Google-Extended se pilotent dans le robots.txt, Google-Agent se pilote dans le pare-feu.
| Nom | Ce qu’il fait | Qui le déclenche | Où on le règle |
|---|---|---|---|
| Googlebot | Explore et indexe vos pages pour la recherche Google | Google, automatiquement | robots.txt |
| Google-Extended | N’est pas un robot : un mot-clé qui dit si vos pages peuvent servir à entraîner Gemini | Personne : c’est une consigne | robots.txt |
| Google-Agent | Navigue et agit sur votre site pour un utilisateur | Un utilisateur, via une IA de Google | Pare-feu, CDN, outil anti-robot |
Googlebot obéit au robots.txt : Google écrit que ses robots d’exploration « always obey robots.txt rules when crawling automatically » (respectent toujours les règles du robots.txt quand ils explorent automatiquement). Google-Extended « doesn’t have a separate HTTP request user agent string » (n’a pas de nom propre dans les visites) : c’est une ligne du robots.txt, et Google précise qu’elle ne change rien à la présence d’un site dans la recherche.
Interdire l’entraînement de Gemini avec Google-Extended ne touche donc pas Google-Agent, et inversement : ce sont deux décisions indépendantes. L’article Bloquer les robots IA : celui qui s’entraîne n’est pas celui qui vous cite détaille la même logique chez OpenAI, Anthropic et Perplexity.
Reconnaître le vrai agent de Google : badge, liste d’invités, passeport
Un vrai Google-Agent se reconnaît à son nom et à une adresse IP que Google publie ; une signature numérique s’y ajoute parfois.
Le videur dispose de trois contrôles, que Google énumère dans cet ordre :
- Le badge : le nom. Chaque visite annonce son identité dans un champ technique appelé User-Agent. Celui de l’agent contient « Google-Agent ». Mais ce badge se falsifie en une ligne : n’importe quel robot peut écrire « Google-Agent ».
- La liste d’invités : l’adresse IP. L’adresse IP est l’adresse réseau d’où part la visite. Google publie celles de son agent dans un simple fichier de liste, user-triggered-agents.json, et demande de vérifier que la visite en vient. Au 18 novembre 2026, ce fichier comptait 20 plages d’adresses, c’est-à-dire 20 blocs d’adresses consécutives (12 au format IPv4, 8 au format IPv6, plus récent ; relevé du fichier). Un imposteur peut copier le badge, pas l’adresse.
- Le passeport tamponné : la signature. Google teste un protocole, Web Bot Auth, qui ajoute à certaines visites une signature numérique vérifiable avec les clés publiques de Google. Il le présente comme un protocole « experimental » (expérimental), et précise : « We don’t sign every request of a particular agent » (nous ne signons pas toutes les requêtes d’un agent donné).
Le troisième contrôle est un bonus, pas une condition. Google le dit lui-même : « Don’t forget to fall back to IP-based verification, as not all requests are signed » (n’oubliez pas de revenir à la vérification par adresse IP, car toutes les requêtes ne sont pas signées). Une règle qui exigerait la signature refoulerait une partie des vrais agents. La signature reste rare chez tous les agents : selon PPC Land, Arkose Labs ne trouvait une signature Web Bot Auth valide que sur 2,3 % des sessions d’agents IA qu’il jugeait légitimes (octobre 2026, tous agents confondus). La bonne règle combine le badge et la liste d’invités, et accepte la signature quand elle est présente.
Le message à envoyer à votre hébergeur ou à votre prestataire
Votre prestataire doit créer une règle qui reconnaît Google-Agent, la placer avant les autres et l’appliquer à tout le parcours, sans CAPTCHA.
Le message ci-dessous traduit en langage clair la règle d’autorisation de Google et les six vérifications qu’il liste quand l’agent reste bloqué. Il se copie tel quel et s’envoie à qui gère votre site : hébergeur, agence, développeur ou équipe technique. Si personne ne sait dire si vous avez un CDN ou un pare-feu, posez d’abord cette question.
Bonjour, Google demande d’autoriser son agent IA, Google-Agent, dans les CDN, pare-feu et outils anti-robot (documentation Google « Allow Google-Agent traffic », 17 novembre 2026). Pouvez-vous vérifier ces points ?
1. Une règle autorise les visites dont le User-Agent contient « Google-Agent » et dont l’adresse IP figure dans le fichier user-triggered-agents.json. La signature Web Bot Auth est acceptée quand elle est présente, sans être exigée.
2. Cette règle passe avant les blocages visant les hébergeurs cloud, les règles anti-robot gérées et les blocages par catégorie « agents IA ».
3. Ces visites ne reçoivent ni CAPTCHA ni défi JavaScript, y compris ceux qui s’affichent sur la recherche ou les formulaires.
4. L’autorisation couvre tout le parcours : recherche interne, filtres, fiches, ajout au panier, réservation, et les appels techniques en arrière-plan (API).
5. Les limites de nombre de visites par adresse IP exemptent ces adresses, partagées par de nombreux utilisateurs.
6. La liste d’adresses est mise à jour automatiquement.
7. Les équipements intermédiaires (répartiteurs de charge, proxys) conservent l’adresse IP d’origine, le User-Agent et les en-têtes de signature.
Merci de me dire ce qui est en place et ce qui ne l’est pas.
Trois points sont souvent oubliés quand on croit avoir « autorisé Google ».
L’ordre des règles. Google demande que l’autorisation passe avant les « broad cloud or data center ASN blocks » (les blocages larges visant des réseaux entiers d’hébergeurs cloud). Une règle anti-cloud appliquée avant refoule l’agent sans que l’autorisation soit lue.
Le parcours entier. Google cite la recherche, les filtres, les fiches, l’« add-to-cart, booking » (l’ajout au panier, la réservation) et les appels techniques qui les font marcher. Un agent bloqué au moment d’ajouter au panier échoue, même s’il a vu la fiche.
Les adresses partagées. Une même adresse IP de Google sert à plusieurs utilisateurs à la fois : « concurrent requests from multiple users share the same egress pool » (les requêtes simultanées de plusieurs utilisateurs sortent par le même ensemble d’adresses). Une limite par adresse (par exemple 100 visites par minute) peut donc couper l’agent sans qu’aucun utilisateur abuse.
Vérifier que la porte est bien ouverte
La preuve qu’un vrai Google-Agent entre se trouve dans les journaux de visites, et de préférence dans ceux du CDN ou du pare-feu, pas seulement dans ceux du serveur.
Les journaux (ou logs) sont les registres où chaque visite est notée : date, adresse IP, User-Agent, réponse donnée. Demandez à votre prestataire d’y chercher « Google-Agent » et de regarder ce qui a été répondu :
- code 200 : la page a été servie, l’agent est entré ;
- code 403 : accès refusé, l’agent a été refoulé ;
- code 429 : trop de visites, une limite l’a arrêté ;
- une page de défi (CAPTCHA, vérification « êtes-vous humain ? ») à la place de la page demandée : l’agent est bloqué, même quand le code renvoyé ne ressemble pas à une erreur.
L’absence de trace ne prouve rien : soit l’agent n’est pas venu, soit le CDN l’a arrêté avant le serveur, et seuls ses journaux le montrent. Chez Cloudflare, le tableau de bord AI Crawl Control liste les robots IA vus sur le site et l’action appliquée à chacun, d’après la documentation de Cloudflare.
Un test maison ne remplace pas ce contrôle. Se faire passer pour Google-Agent en changeant son User-Agent ne vérifie que le badge : la visite part de votre adresse IP, donc la règle d’autorisation ne la reconnaît pas, et elle est traitée comme n’importe quelle visite. Qu’elle passe ou qu’elle soit bloquée, le résultat ne dit rien de ce que vit le vrai agent.
Ce que Google documente, ce qui est déduit, ce qu’on ignore
| Affirmation | Statut | Source |
|---|---|---|
| Google-Agent navigue et agit sur le web à la demande d’un utilisateur | Documenté | Google, page « Allow Google-Agent traffic » |
| Il ignore généralement le robots.txt | Documenté | Google, page des robots déclenchés par l’utilisateur |
| Il se reconnaît à son User-Agent et à une adresse IP publiée | Documenté | Google, page « Allow Google-Agent traffic » |
| Le fichier d’adresses comptait 20 plages au 18 novembre 2026 | Relevé | Fichier user-triggered-agents.json |
| Seule une partie de ses visites est signée | Documenté | Google, page Web Bot Auth |
| Depuis le 15 septembre 2026, Cloudflare propose aux nouveaux sites avec publicité un préréglage qui bloque la catégorie Agent sur les pages avec publicité | Documenté | Blog Cloudflare, 15 septembre 2026 |
| La protection anti-robot bloquait un agent d’achat IA sur 29 des 200 sites marchands audités | Observé (autre agent que Google-Agent) | Audit Blend, rapporté par PPC Land |
| Google-Agent fait partie de cette catégorie chez Cloudflare | Non documenté | Cloudflare ne publie pas son classement |
| Les services Google qui utilisent Google-Agent aujourd’hui | Non documenté | Google citait Project Mariner en mars 2026 ; sa page actuelle ne nomme aucun produit |
| Le nombre de visites que Google-Agent apporte à un site | Non documenté | Aucun chiffre publié |
| Bloquer Google-Agent ne change rien à l’indexation par Googlebot | Déduit | Deux robots distincts, réglés à deux endroits |
| Un test avec un faux User-Agent dit si le vrai agent passe | Faux | L’adresse IP n’est pas celle de Google : la règle d’autorisation ne s’applique pas |
Questions fréquentes
Quels services Google utilisent Google-Agent ?
Sa page actuelle n’en nomme aucun. En mars 2026, Google citait en exemple Project Mariner, son agent de navigation expérimental, selon Search Engine Journal. Mariner a fermé le 4 mai 2026 ; selon Android Headlines, sa technologie a été intégrée à Gemini Agent et à Chrome. Google ne dit pas aujourd’hui quel produit envoie Google-Agent.
Cloudflare bloque-t-il Google-Agent par défaut ?
Il n’existe pas de réponse publique. Le préréglage proposé aux nouveaux sites avec publicité bloque la catégorie Agent sur ces pages, mais Cloudflare ne dit pas si Google-Agent en fait partie. Son annuaire public, Cloudflare Radar, le classe parmi les robots vérifiés, c’est-à-dire reconnus par Cloudflare. Le tableau de bord AI Crawl Control de votre compte montre l’action réellement appliquée.
Laisser passer Google-Agent est-il risqué pour la sécurité ?
La règle recommandée par Google n’ouvre la porte qu’aux visites qui portent le bon nom et viennent d’une adresse publiée par Google ; les autres protections restent en place. L’agent emprunte les mêmes pages qu’un visiteur : un espace protégé par un mot de passe reste fermé sans identifiants.
Bloquer Google-Agent nuit-il à mon référencement ?
Rien ne l’indique. L’indexation passe par Googlebot, un robot distinct réglé dans le robots.txt, et Google ne relie pas Google-Agent au classement. En revanche, un agent bloqué ne peut pas finir la tâche qu’un utilisateur lui a confiée sur votre site : pour une réservation ou un achat, la demande part ailleurs.
Sources
- Google, « Allow Google-Agent traffic », 17 novembre 2026 — developers.google.com
- Google, « Google user-triggered fetchers », mis à jour le 19 août 2026 — developers.google.com
- Google, « Google common crawlers », mis à jour le 30 octobre 2026 — developers.google.com
- Google, « Authenticate requests with Web Bot Auth (experimental) », mis à jour le 13 octobre 2026 — developers.google.com
- Google, fichier user-triggered-agents.json, généré le 18 novembre 2026 — developers.google.com
- Cloudflare, billet de blog sur les préréglages IA des nouveaux domaines, 15 septembre 2026 — blog.cloudflare.com
- Cloudflare, « Manage AI crawlers », documentation AI Crawl Control — developers.cloudflare.com
- Cloudflare Radar, fiche du robot Google-Agent — radar.cloudflare.com
- Search Engine Land, « Google-Agent user agent identifies AI agent traffic in server logs », 2026 — searchengineland.com
- Search Engine Journal, article citant la documentation Google de mars 2026 (« for example, Project Mariner »), 30 mars 2026 — searchenginejournal.com
- PPC Land, « Google lists six ways sites still block its AI agent after allowing it », 17 novembre 2026 (audit Blend, mesure Arkose Labs) — ppc.land
- Android Headlines, « Project Mariner is Over: Google Folds its AI Web Agent into Gemini & Chrome », 7 mai 2026 — androidheadlines.com